Apache Kafka — это открытая распределённая платформа потоковой передачи событий. Её можно использовать как систему обмена сообщениями для чтения и записи потоковых данных, публикации и подписки на сообщения. Она также подходит для создания масштабируемых приложений потоковой обработки в сценариях реального времени и для интеграции с базами данных с надёжным хранением потоковых данных в распределённом, реплицируемом и отказоустойчивом кластере. Создаваемые ею «потоки событий» — это «центральная нервная система» передачи данных.
Если вы планируете записывать данные из Kafka в кластер YMatrix, этот документ вам пригодится. База данных YMatrix поддерживает бесшовное подключение к Kafka: данные Kafka непрерывно и автоматически импортируются в таблицы YMatrix, управление поддерживается через графический интерфейс. В настоящее время поддерживаются форматы данных CSV и JSON. Мы рассмотрим простейший пример подключения данных Kafka с помощью платформы управления YMatrix.
Сначала настройте работоспособную среду Kafka, следуя официальному руководству Kafka Quickstart.
После настройки среды Kafka на сервере перейдите в каталог установки (или используйте другой способ входа).
$ cd packages/kafka_2.13-3.2.0Затем запустите службу Kafka и создайте тестовый топик (Topic); порт по умолчанию — 9092.
$ bin/kafka-topics.sh --create --topic csv_test --bootstrap-server localhost:9092Запишите по одной несколько тестовых записей; завершите ввод сочетанием ctrl-c:
$ bin/kafka-console-producer.sh --topic csv_test --bootstrap-server localhost:9092
>1,Beijing,123.05,true,1651043583,1651043583123,1651043583123456
>2,Shanghai,112.95,true,1651043583,1651043583123,1651043583123456
>3,Shenzhen,100.0,false,1651043583,1651043583123,1651043583123456
>4,Guangxi,88.5,false,1651043583,1651043583123,1651043583123456
>^C
Приведённая выше команда записала 4 записи в только что созданный топик csv_test — 4 строки CSV с разделителями-запятыми.
Подготовка завершена. Далее описано создание потока данных Kafka для импорта данных.
Введите в браузере IP-адрес машины с MatrixUI (по умолчанию — IP-адрес master-узла) и номер порта:
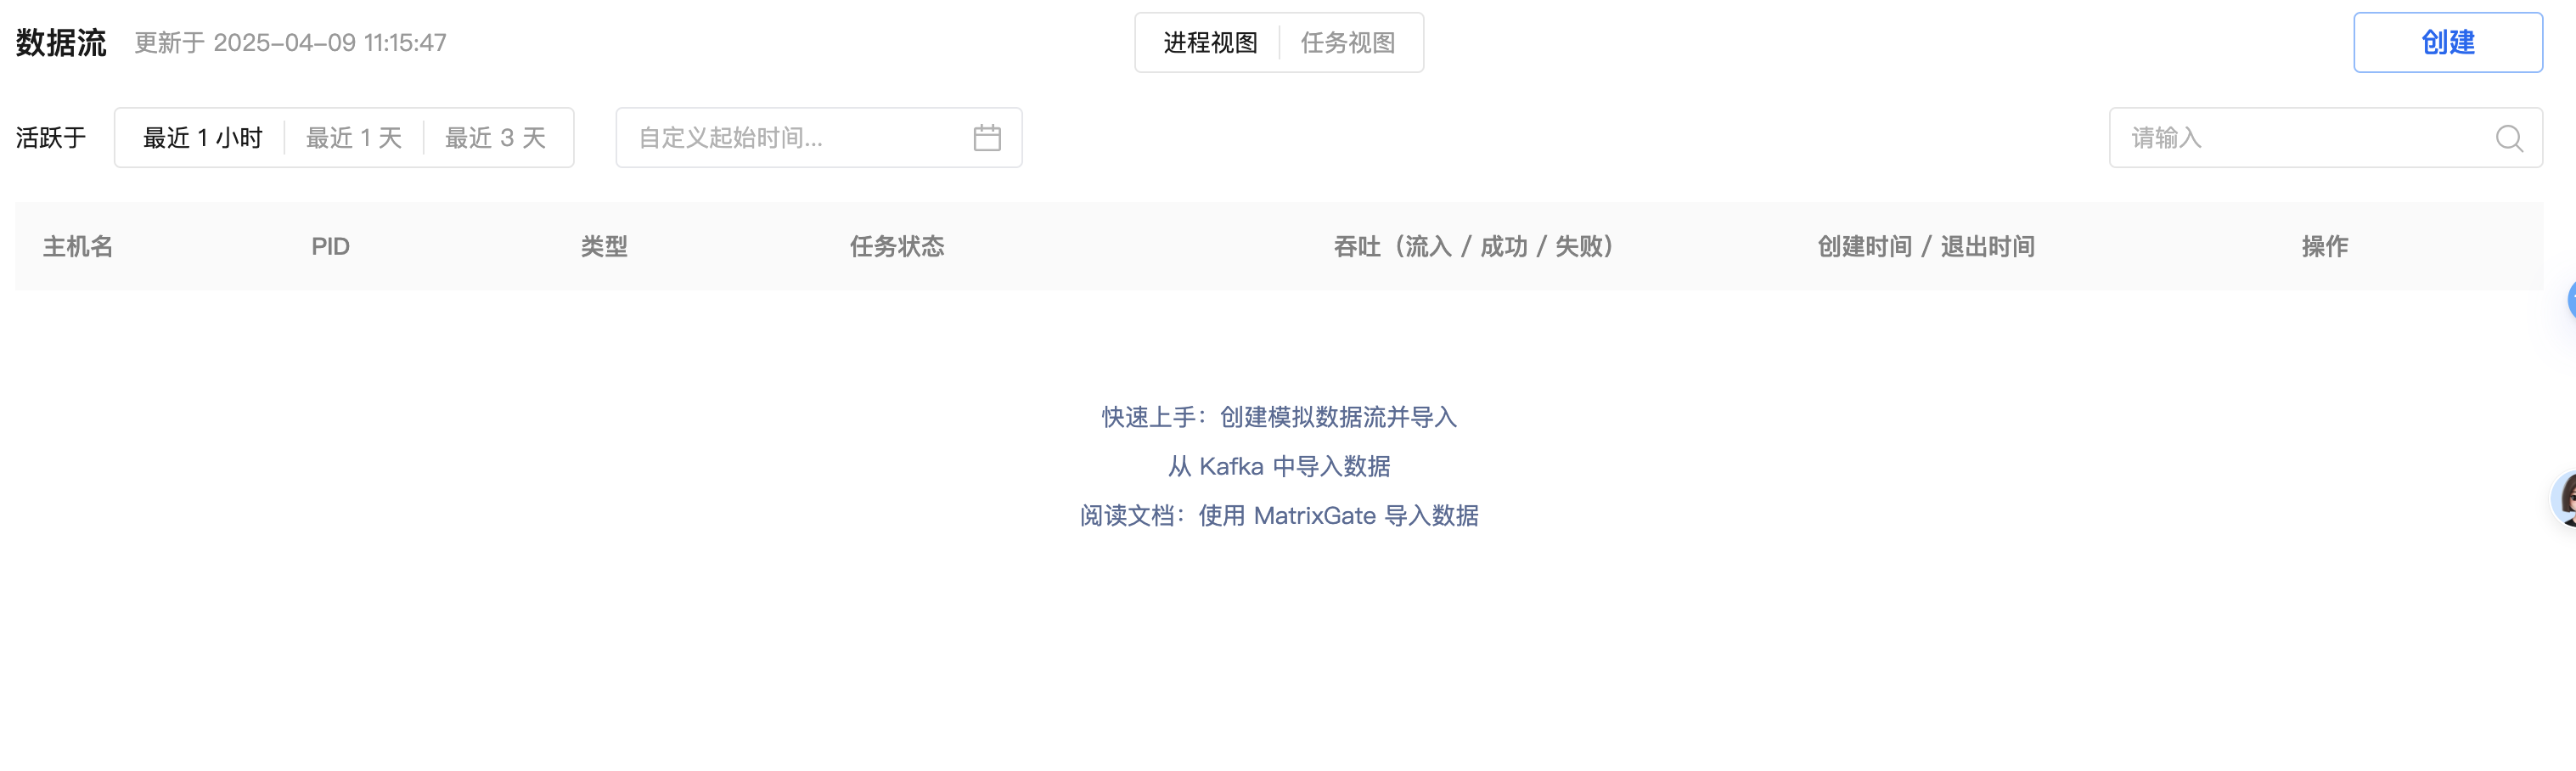
http://<IP>:8240После успешного входа открывается главный интерфейс, разделённый на представления Processes и Tasks. Processes — это запущенные процессы MatrixGate, Tasks — это все задачи импорта данных. Один процесс MatrixGate может содержать несколько задач.
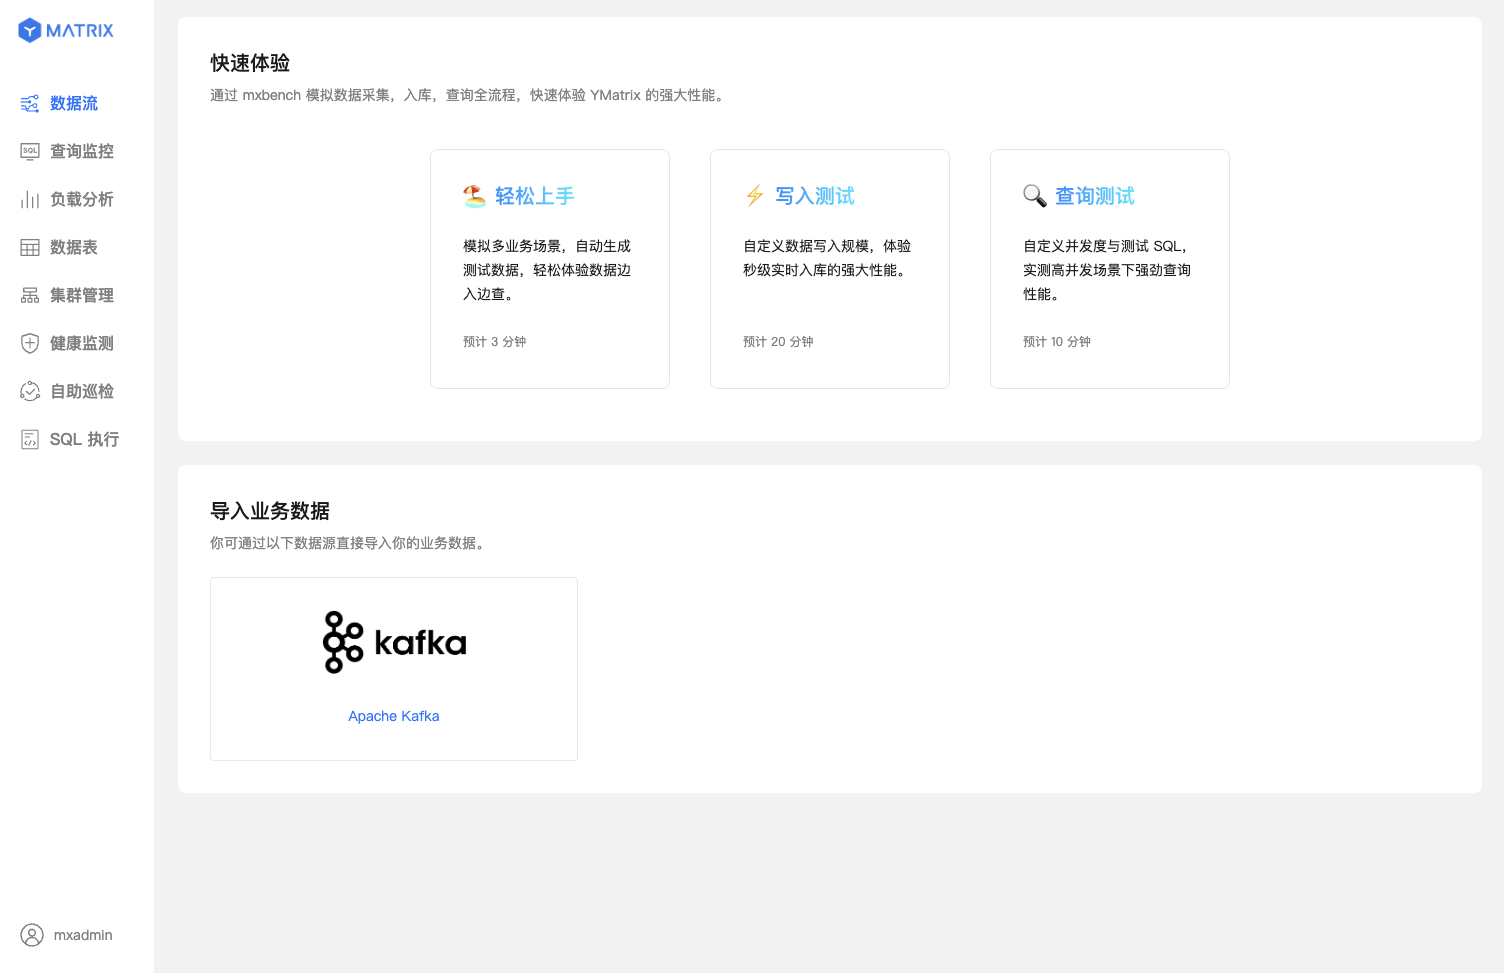
Нажмите «Import Data from Kafka».
Выберите источник данных Kafka. Сначала рассмотрим шаги на примере файла CSV.
Сначала можно выбрать существующую таблицу или создать новую — она станет целевой таблицей для приёма данных Kafka.
2.1.1.1 Выбор существующей таблицы
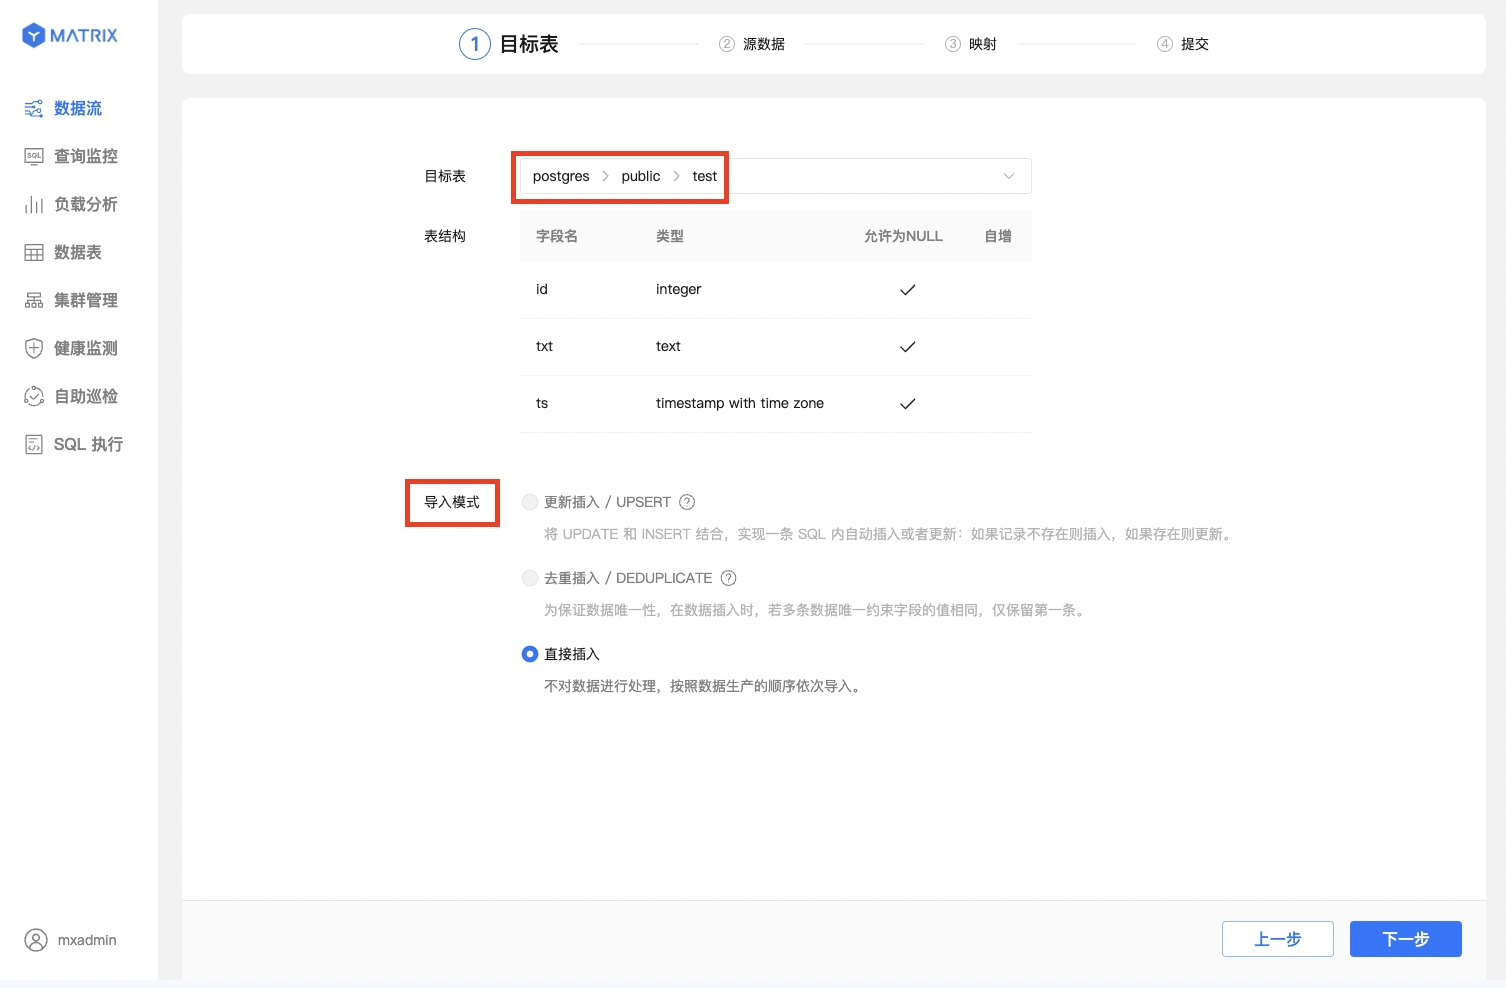
В поле Target table выберите существующую таблицу и режим импорта данных (Importing mode). Предположим, выбрана таблица test в схеме public базы данных postgres. После выбора ниже отображается структура таблицы (имена столбцов, типы, допустимость NULL, автоинкремент) для проверки столбцов.
Режим импорта данных определяет способ обработки повторяющихся данных; выберите его с учётом ограничений целевой таблицы:
2.1.1.2 Создание новой таблицы
При создании новой таблицы предположим, что схема — public, имя таблицы — test1.
При создании новой таблицы сначала выберите тип таблицы (Table type):
При создании новой таблицы структуру таблицы на этом шаге задавать не нужно: имена и типы столбцов определяются на шаге 3 «Mapping» — автоматическим сопоставлением или вручную. Режим импорта поддерживает только UPSERT и INSERT.
При выборе «Partitioned table» ниже появляются настройки «Automatic partition»:

При выборе «Non-partitioned table» автоматическое разбиение не применяется:

После успешного создания таблицы появляется красная метка New.
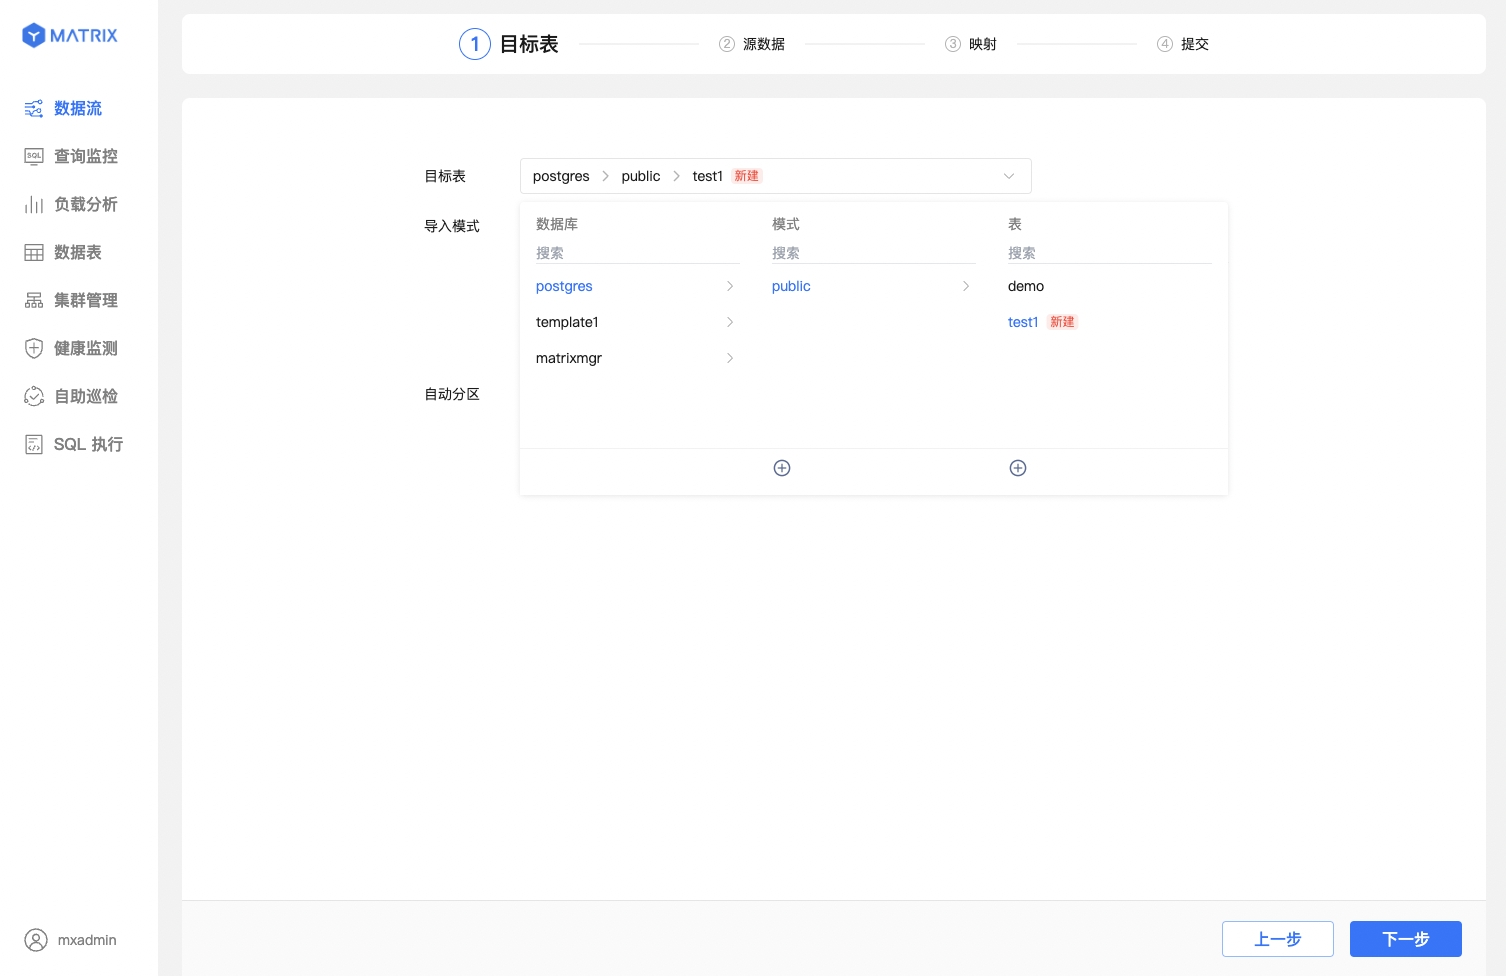
Для неё выберите режим импорта данных и стратегию автоматического разбиения (Automatic partition). По умолчанию используется стратегия auto_partitioning. Для Non-partitioned table выбирается только режим импорта данных, стратегия автоматического разбиения не применяется.

После выбора целевой таблицы на втором шаге настройте подключение к источнику данных. Для перехода к следующему шагу выполните следующие действия:
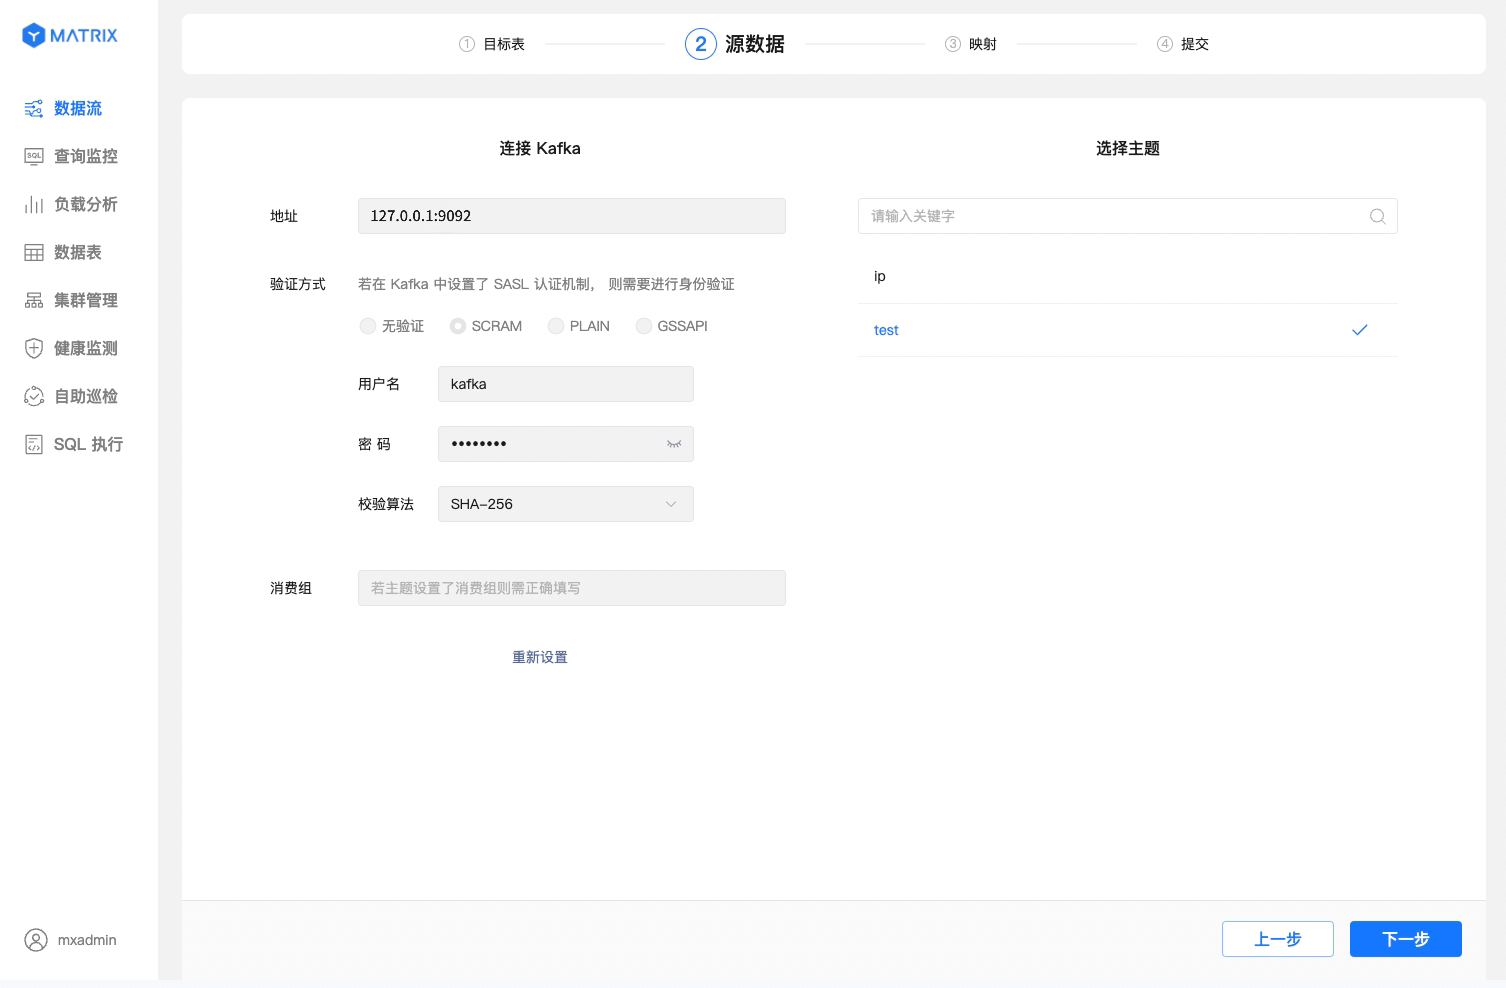
Адрес и данные аутентификации можно сохранить как «Kafka profile» для повторного использования: после заполнения нажмите «Save as profile», введите имя профиля в диалоге «Save Kafka profile» и сохраните. При создании потока данных можно напрямую выбрать сохранённый профиль; интерфейс отобразит «Using profile:

При выборе способа аутентификации GSSAPI необходимо загрузить файлы keytab и Kerberos:

Если подключение GSSAPI не удаётся, проверьте опцию DisablePAFXFAST в области аутентификации: при её включении быстрая аутентификация GSSAPI (PAFXFAST) не используется; в некоторых окружениях Kerberos для подключения необходимо отключить быструю аутентификацию.
На третьем шаге настройте Sample data и выполните сопоставление с существующей или новой таблицей для импорта данных Kafka.
2.1.3.1 Базовая конфигурация
Выберите формат исходных данных CSV и задайте или настройте Sample data. Чтобы сопоставление было точным, необходимо указать или вручную настроить формат Sample data.
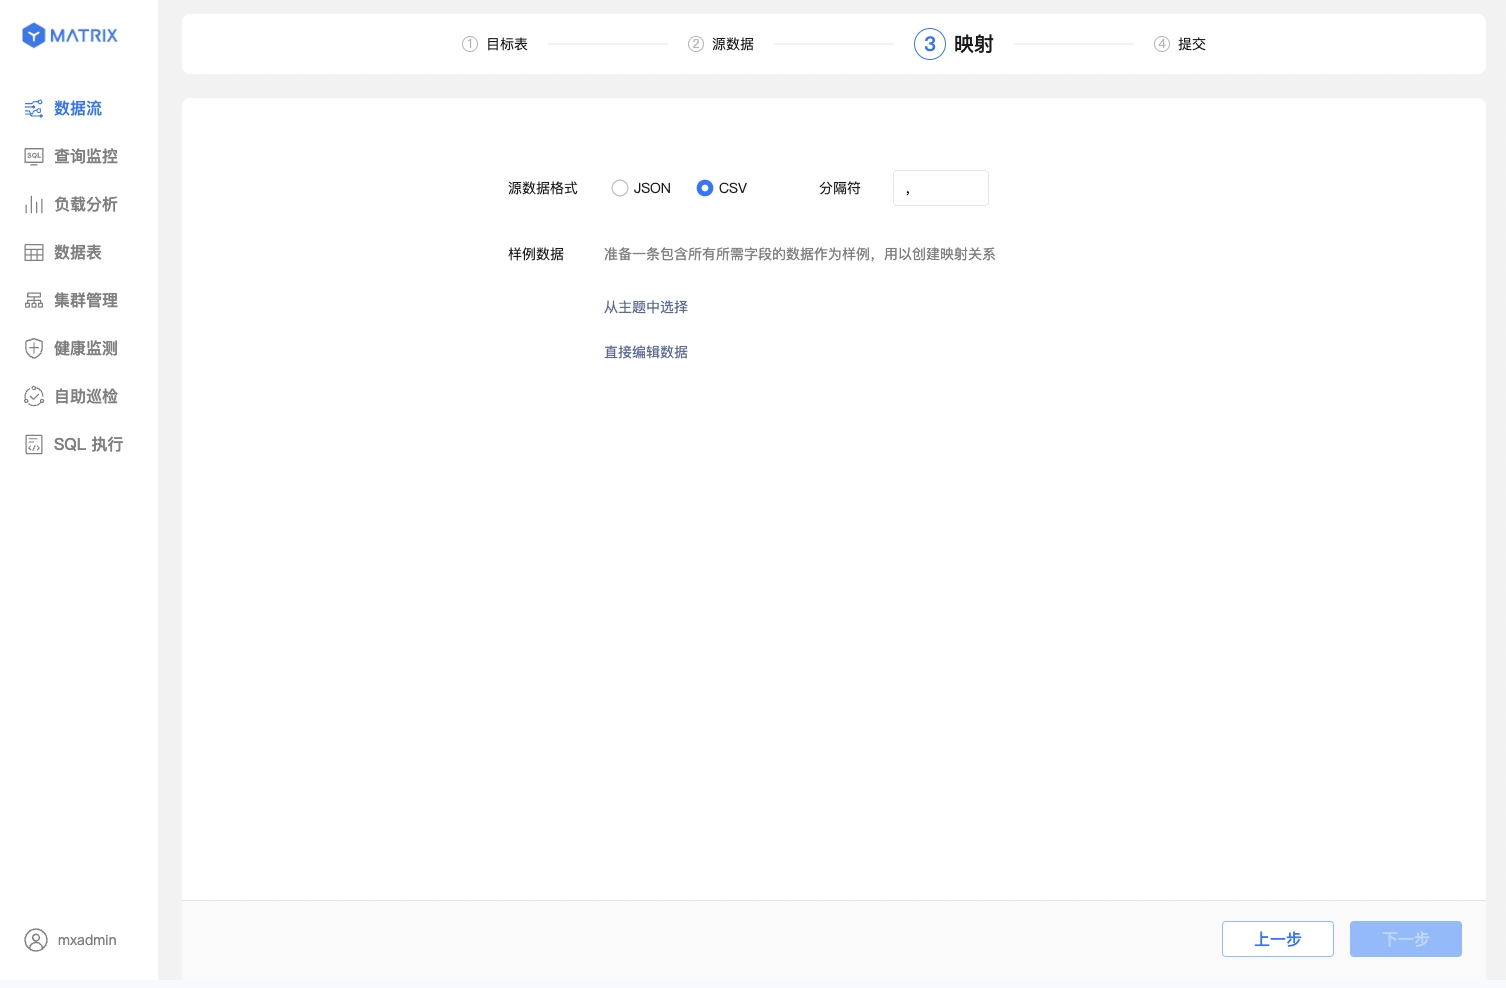
При настройке Sample data можно Select from topic или Edit data directly.
Edit data directly и укажите одну строку Sample data в соответствии со структурой столбцов целевой таблицы. Эта строка используется только для разбора и сопоставления структуры столбцов и не импортируется в целевую таблицу.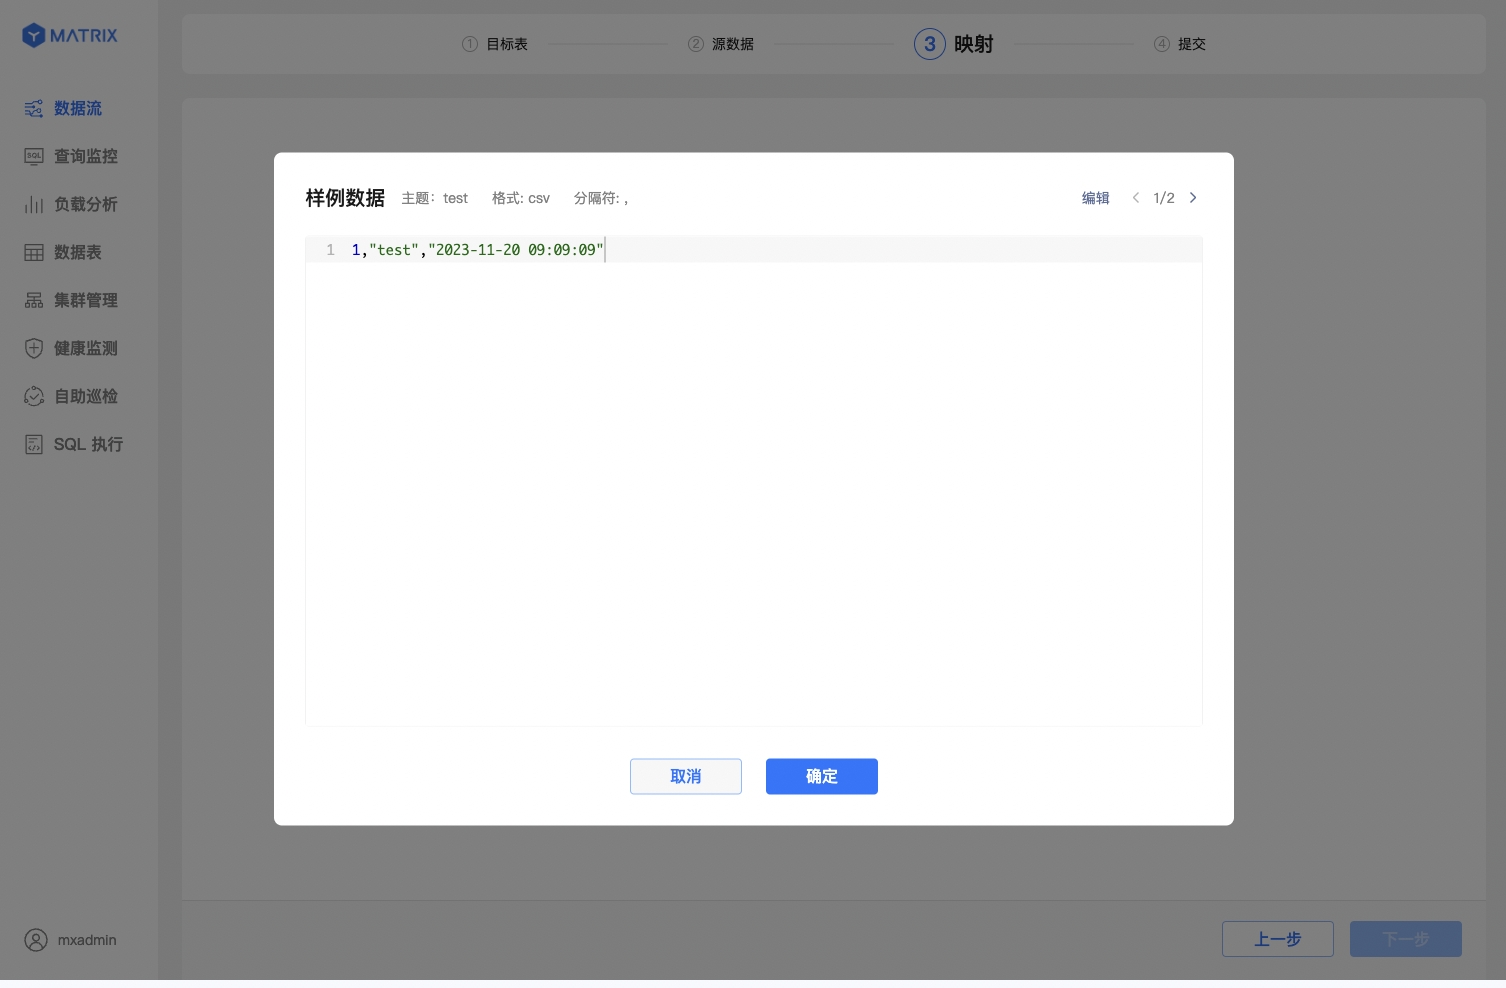
Примечание!
Таблицы, созданные через графический интерфейс, по умолчанию используют движок хранения MARS3. Подробнее см. MARS3
2.1.3.2 Выполнение сопоставления
После базовой настройки выполните сопоставление столбцов исходных данных со столбцами целевой таблицы. Порядок действий для существующих и новых таблиц различается.
Сопоставление существующей таблицы
Сначала выберите строку Sample data, затем найдите соответствующий целевой столбец в правилах сопоставления; после настройки нажмите сохранение — правило сопоставления создано.
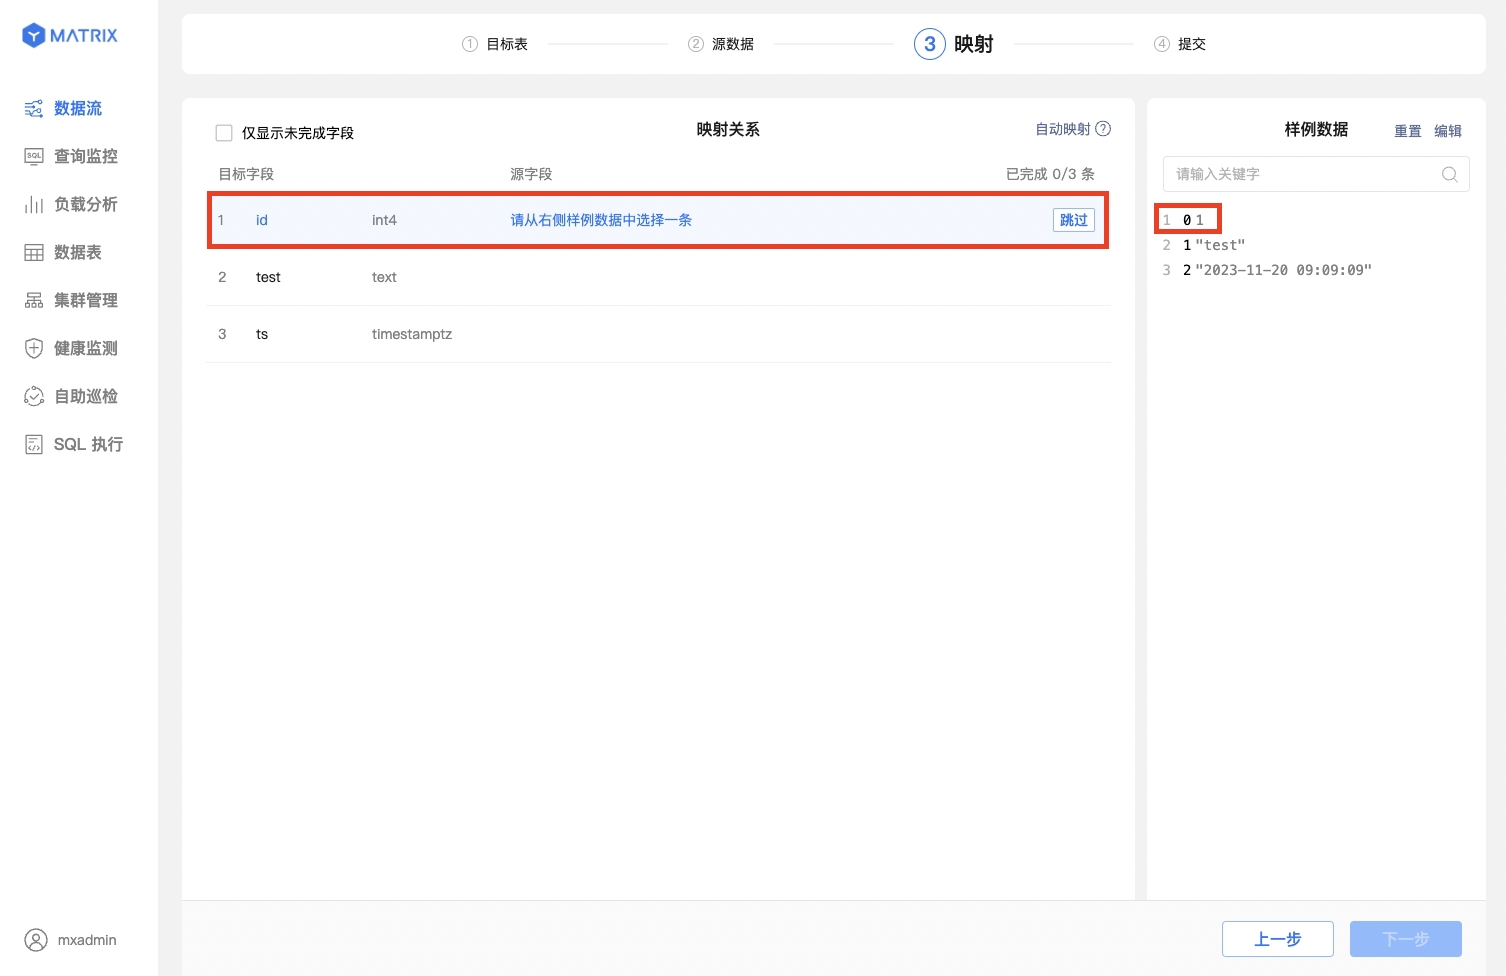
Можно также выполнить автоматическое сопоставление (Automatic mapping) одной кнопкой — это удобно и сохраняет корректность сопоставления. Начиная с 6.8.4 имена столбцов, сформированные автоматическим сопоставлением, не содержат лишних подчёркиваний и лучше читаются.

После автоматического сопоставления для каждого столбца отображается выходное значение; в любой момент можно «Clear» или «Edit»:

Сопоставление новой таблицы
Помимо создания правил сопоставления, для новой таблицы обратите внимание на следующие настройки:
когда значение исходного столбца — UNIX-временная метка, а тип целевого столбца выбран timestamptz, справа от выходного значения появляется флажок Store as timestamp. Если флажок установлен, выходное значение автоматически преобразуется в формат timestamp базы данных.
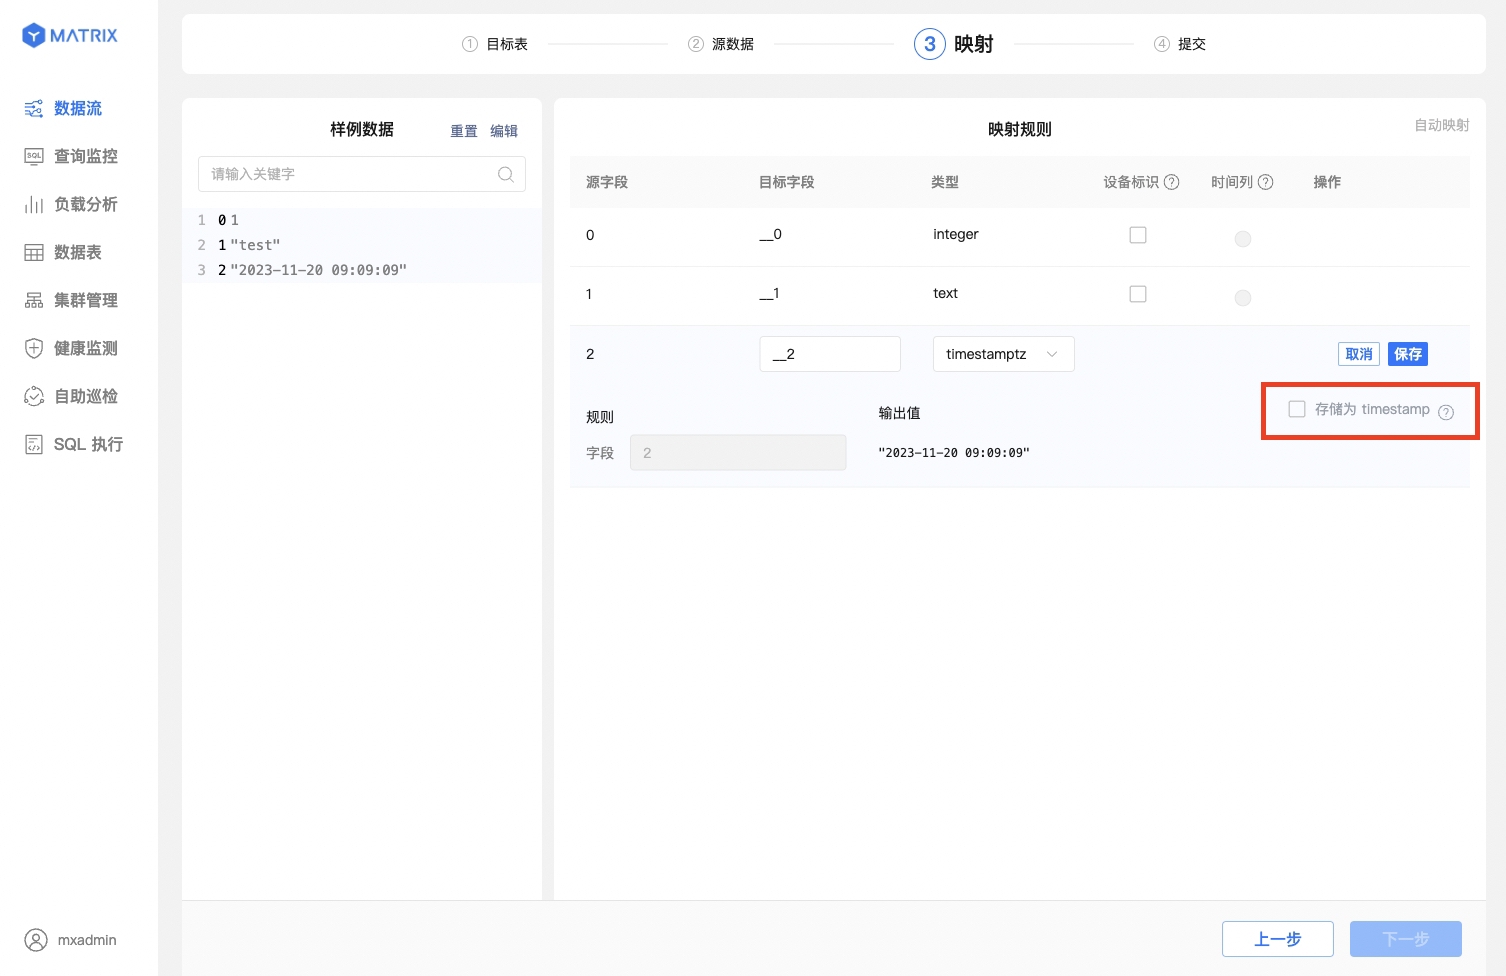
После сохранения правил сопоставления необходимо также подтвердить две настройки: «Device ID (unique identifier)» и «Time column»:
timestamptz); для Non-partitioned table выбор столбца времени не требуется.
На странице сопоставления новой таблицы по сравнению с существующей таблицей добавлен столбец «Device ID (unique identifier)»:

Наконец, проверьте все конфигурации потока данных: при наличии ошибок вернитесь и исправьте их, при отсутствии — выполните отправку.
2.1.4.1 Существующая таблица
На странице отображаются все конфигурации потока данных; после проверки нажмите кнопку «Submit».
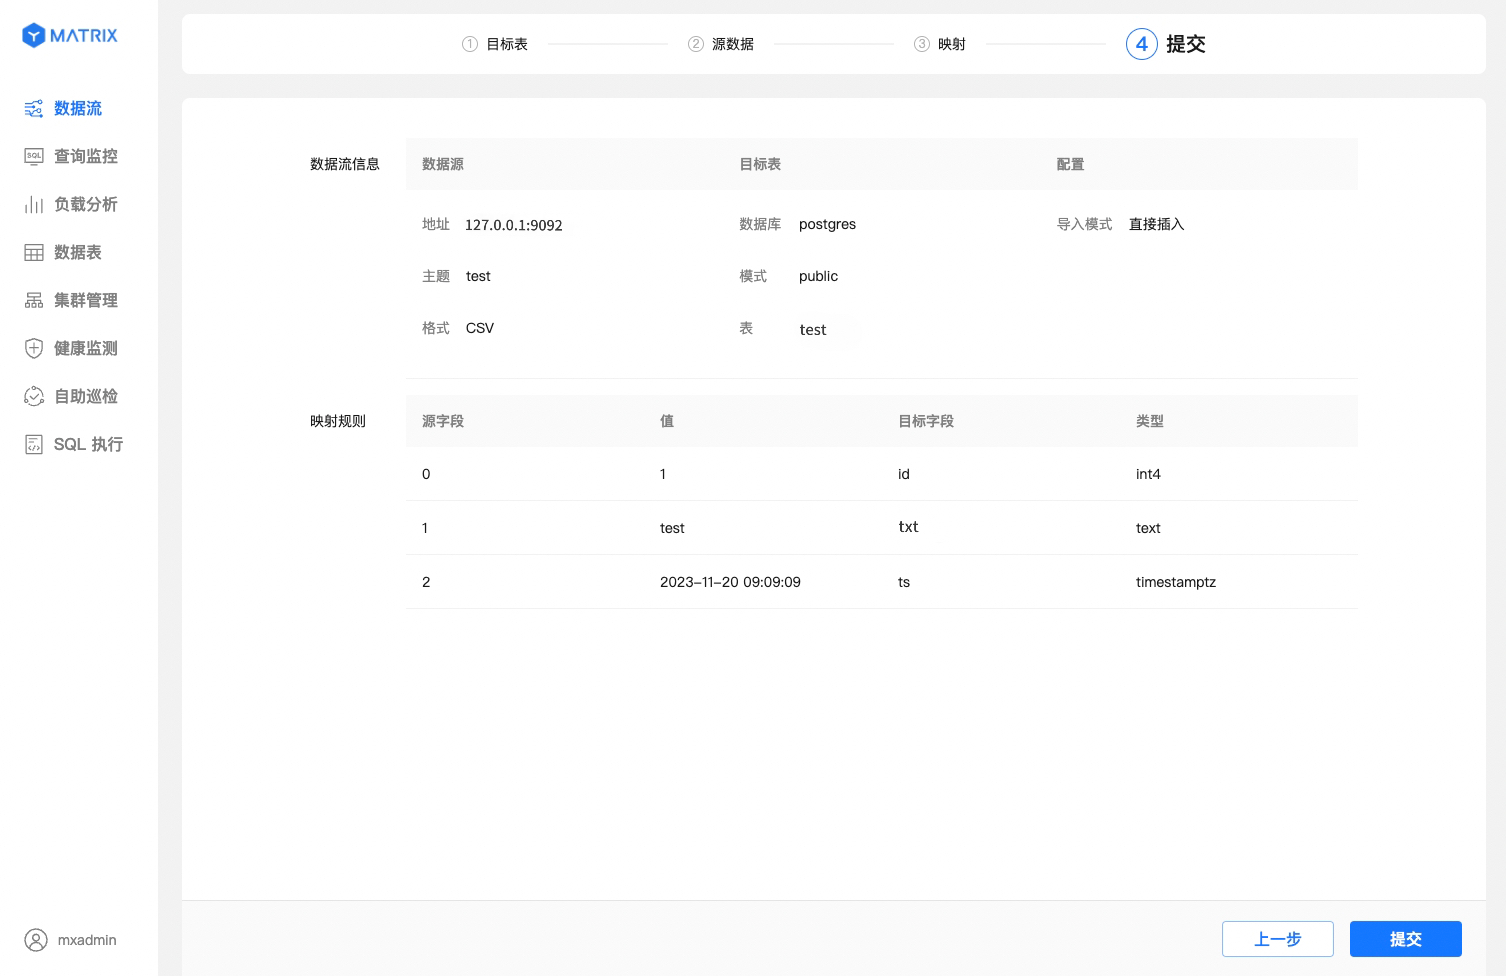
2.1.4.2 Новая таблица
По сравнению с существующей таблицей дополнительно отображается информация об уникальном идентификаторе: для Partitioned table — комбинация «Device ID + Time column»; для Non-partitioned table информация об уникальном идентификаторе не отображается. После проверки нажмите кнопку «Submit».
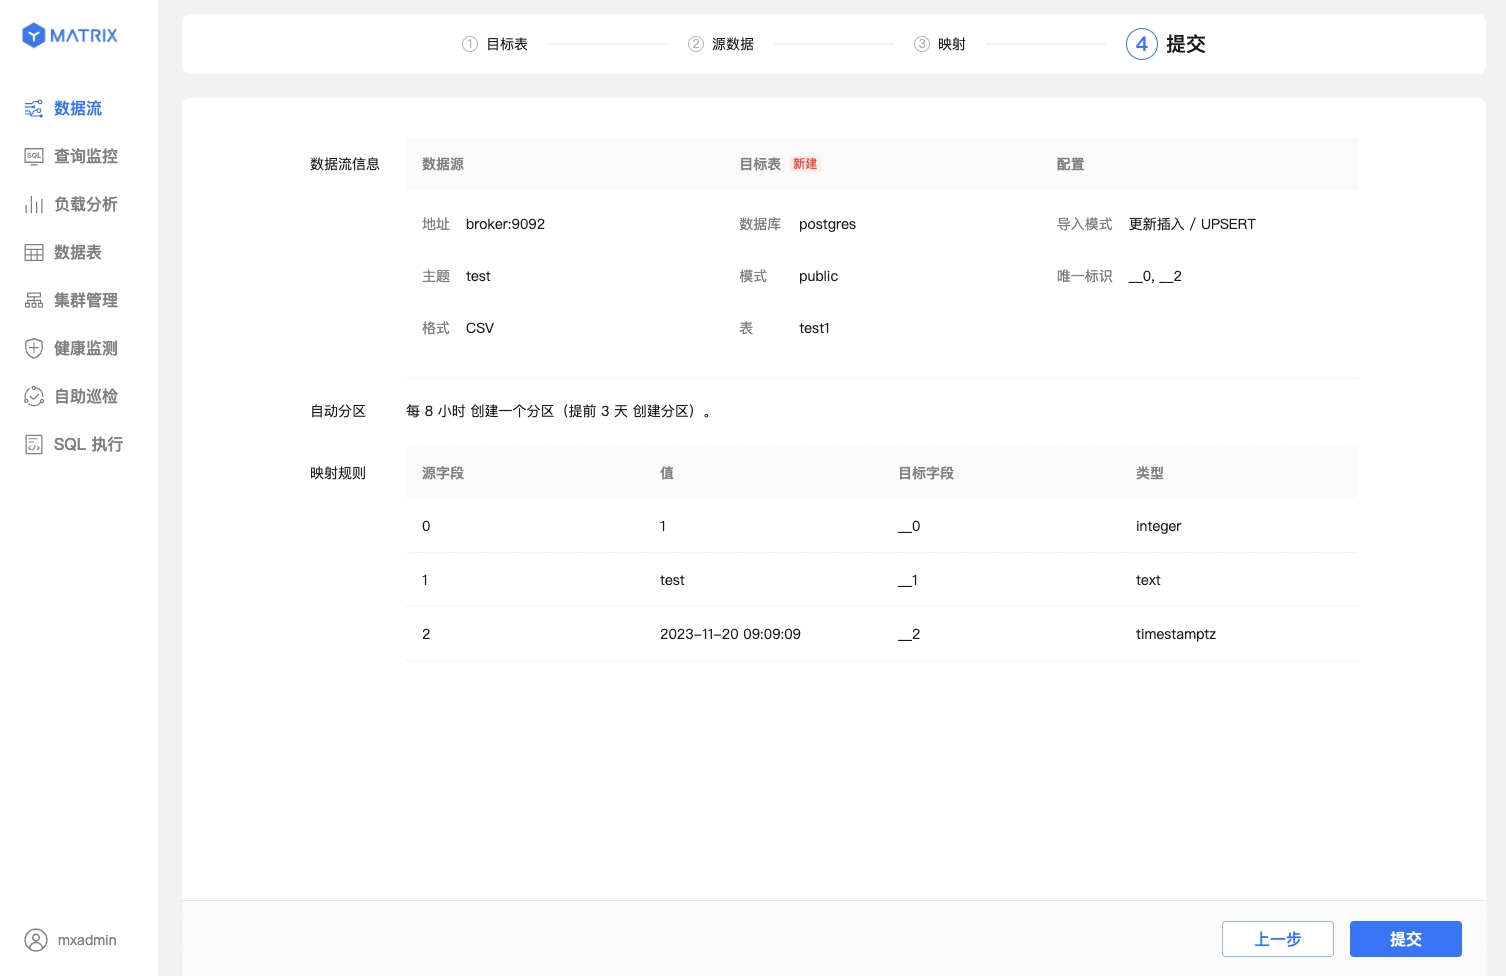
Начиная с 6.8.4, на странице Submission также отображаются тип таблицы (Table type) и режим импорта (Importing mode) целевой таблицы:

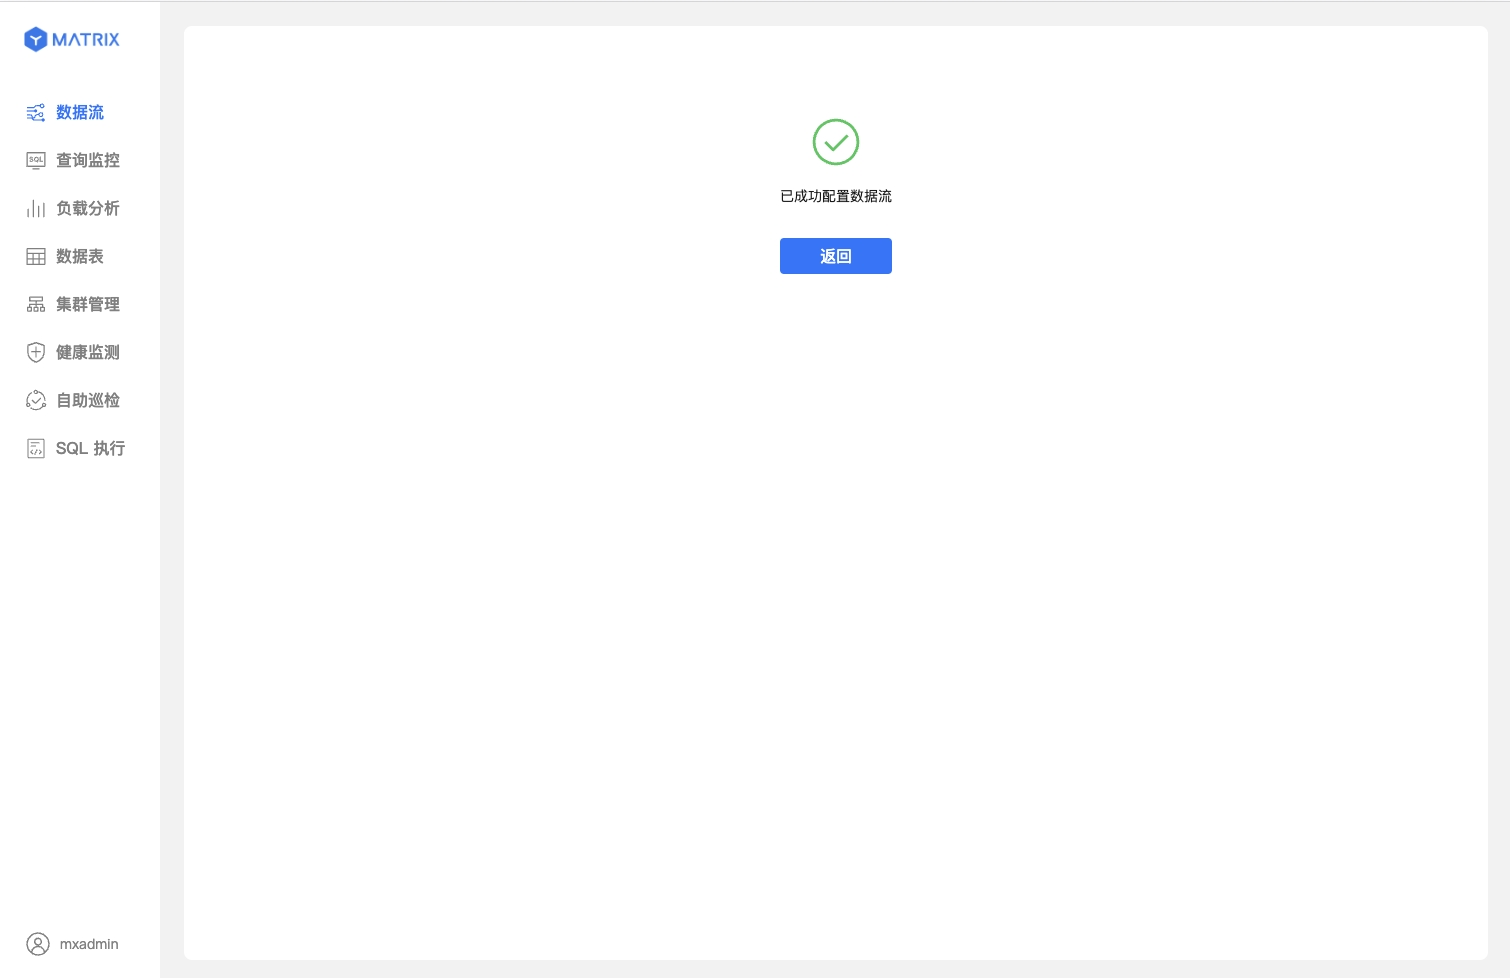
И для существующей, и для новой таблицы после успешной отправки открывается страница с сообщением об успешном создании — поток данных Kafka создан.
Здесь описаны в основном отличия от подключения в формате CSV; они касаются шага Mapping.
Сначала выберите формат данных JSON и настройте Sample data.
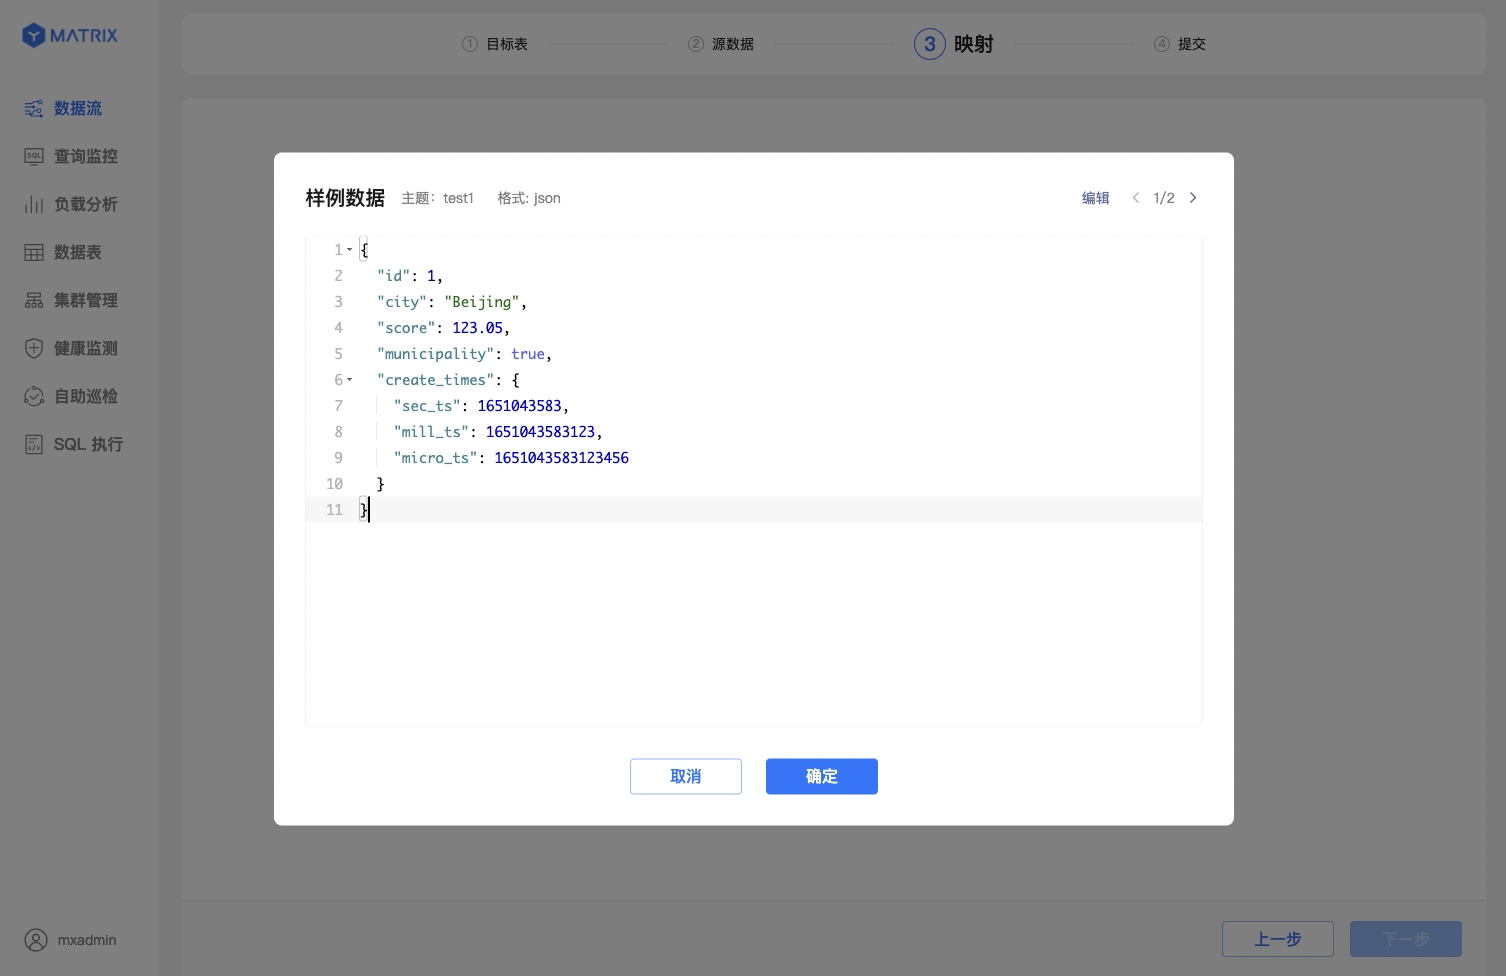
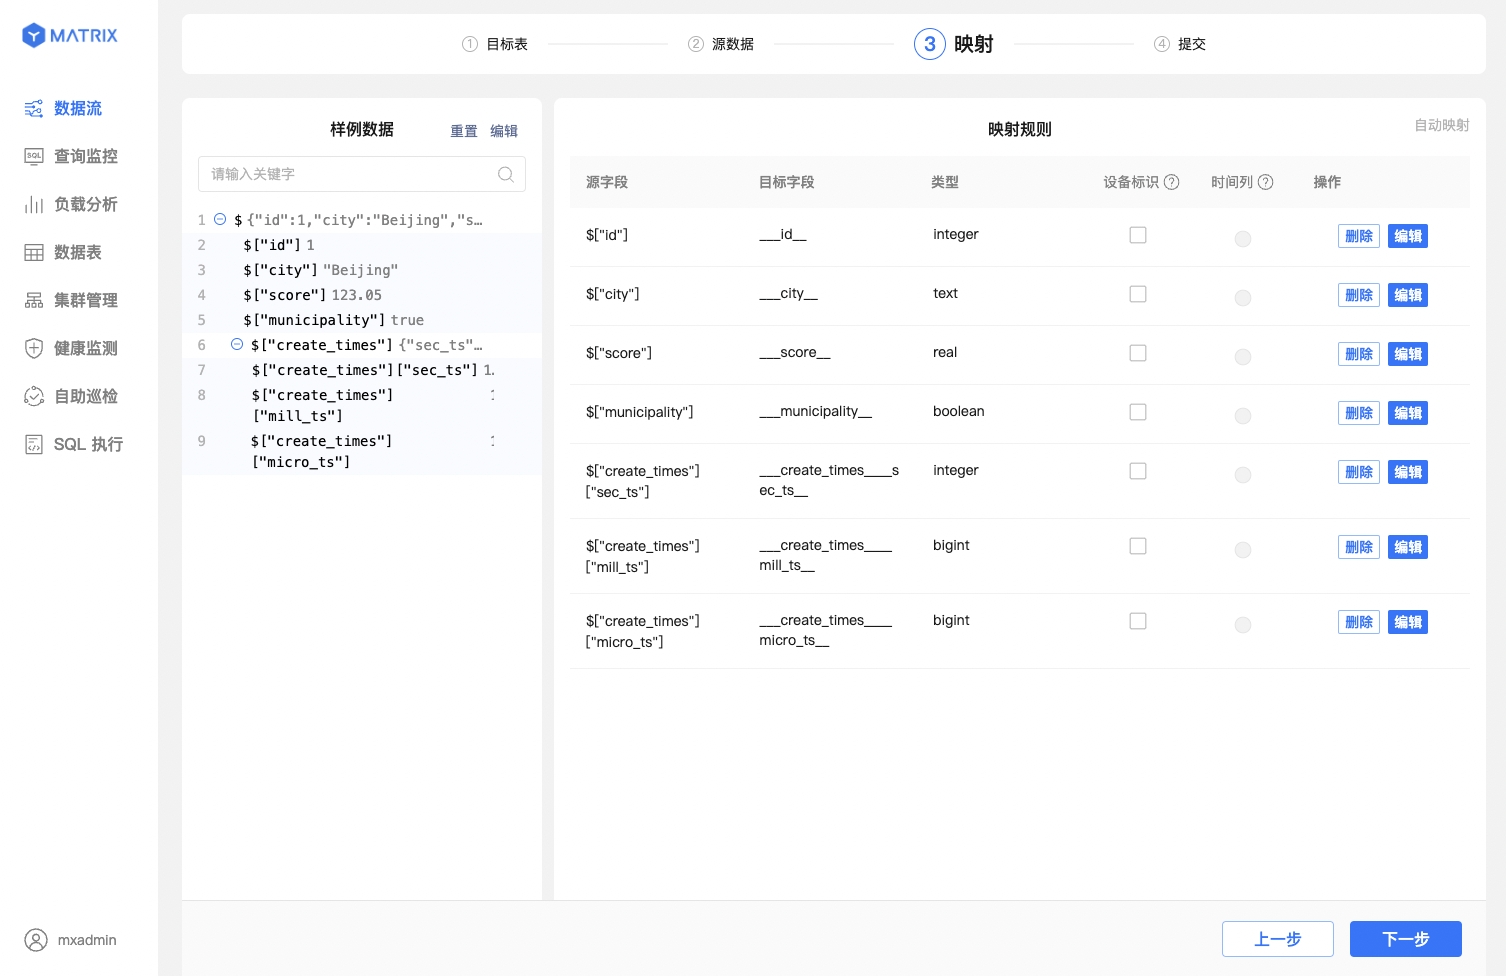
Затем для индексации столбцов JSON используется семантика $["имя_столбца"]; правила индексации см. в JSONPath.
Наконец, данные JSON поддерживают многоуровневую вложенность; YMatrix позволяет выбирать столбцы исходных данных разных уровней для создания правил сопоставления. Нажмите ⊕ в столбце Sample data, чтобы развернуть уровни вложенности.
После создания потока данных Kafka через графический интерфейс YMatrix данные непрерывно импортируются в YMatrix. Если импорт необходимо временно прервать (например, для отладки службы), можно приостановить или остановить задачу в графическом интерфейсе, а затем возобновить или запустить её.
Для работающих потоков данных Kafka импорт управляется из двух представлений: Processes (управление всеми задачами процесса MatrixGate) и Tasks (управление отдельными задачами).
Примечание!
Операции запуска, остановки и приостановки могут вступать в силу в течение 1–10 секунд; в это время не выполняйте с потоком данных других операций. После приостановки или остановки импорт данных Kafka прекращается; после возобновления или запуска импорт возобновляется немедленно, а страница снова отобразит актуальные сведения об импорте не позднее чем через 5 секунд.
Представление Processes выводит для каждого процесса MatrixGate имя хоста, PID, тип, состояние задач, пропускную способность и время создания/выхода; завершённые процессы остаются в списке.

По кнопке «View» в столбце операций открывается страница сведений о процессе с тремя вкладками: «Performance», «Active tasks», «Basic info»:

Кнопка «···» в строке списка управляет всеми задачами процесса и позволяет удалить запись о процессе из списка:

Кнопка раскрытия в меню операций позволяет выполнить операции Start, Reset offsets, Stop и Remove task.
По умолчанию в списке задач отображаются только задачи с фильтром «Active in: last hour»; для просмотра более ранних задач измените фильтр времени.
Если необходимо возобновить потребление из другой позиции Kafka — например, повторно импортировать данные после случайного удаления или пропустить накопившиеся данные, — можно сбросить позиции потребления остановленного потока данных. Функция поддерживается начиная с 6.8.4; работать с ней можно в представлении Tasks графического интерфейса или с помощью команды mxgate offset-reset.
Примечание!
Сброс позиций — офлайн-операция. Сначала остановите задачу и убедитесь, что все связанные процессы MatrixGate завершены, и только затем выполняйте сброс позиций.
Примечание!
Повторное потребление следует семантике доставки «хотя бы один раз». Убедитесь, что целевая таблица может обрабатывать повторяющиеся данные, например с помощью режима UPSERT или режима удаления дубликатов.
Остановите целевую задачу в представлении Tasks.
Нажмите «Reset offsets» и на странице «Reset consumer offsets» выберите позицию возобновления потребления:
0:100,1:200
При выборе «First message at or after a date and time» укажите дату и время:

Нажмите «Generate plan», чтобы просмотреть сведения о Topic, группе потребителей, целевой таблице, Retained start, Log end, Consumed to, Consume from, Catalog rows to purge и т. д.; после проверки нажмите «Confirm reset».

После завершения сброса запустите задачу в представлении Tasks; потребление продолжится с новой позиции.
mxgate offset-reset сбрасывает позиции потребления остановленного потока данных. Команда читает конфигурацию потока данных из файла, указанного в -C, используя его только для поиска потока данных; файл конфигурации не изменяется.
Предварительные требования
Указание целевой позиции (необходимо указать ровно один из четырёх способов)
| Параметр | Описание |
|---|---|
--to-earliest |
Сброс к самой ранней позиции, всё ещё сохранённой в Kafka |
--to-latest |
Сброс к концу журнала с пропуском накопившихся данных |
--to-datetime <время> |
Сброс к первому сообщению в указанное время или позже; время в формате RFC3339 с часовым поясом, например 2026-08-28T10:00:00+08:00 |
--to-offsets <раздел:позиция,...> |
Указание позиций по разделам, например 0:100,1:200 |
Выбор потока данных для сброса
--topic, --consumer-group, --job используются только для сопоставления с уже существующими потоками данных в файле конфигурации и не переопределяют и не собирают временную конфигурацию.
--topic, --consumer-group, --job. У simple consumer нет consumer group, поэтому --consumer-group опускается.Дополнительные параметры
| Параметр | Описание |
|---|---|
-C, --config |
Файл конфигурации потока данных |
--dry-run |
Только показать план, ничего не изменяя |
-y, --yes |
Пропустить интерактивное подтверждение; удобно для автоматизации |
--output |
Формат вывода: text или json. json выводит в stdout один объект; используется вместе с --dry-run или -y |
Пример: предпросмотр плана
Если в файле конфигурации только один поток данных, параметры выбора указывать не нужно:
$ mxgate offset-reset -C mxgate.conf --to-earliest --dry-runСначала команда предупредит, что это офлайн-операция, а затем покажет план. Приведённый вывод — примерный; фактический вывод зависит от конкретного окружения:
offset-reset is an offline command. Before continuing, make sure that
  - every mxgate instance running this flow is stopped and its process has exited;
  - nothing restarts it (systemd, Kubernetes, ...) until this command has succeeded or you have recovered from its error.
Only the consumer group is checked for live members; a simple consumer that is still running cannot be detected.

Offset reset plan of topic csv_test (job job_csv_to_public.demo_csv -> "public"."demo_csv", consumer group "", mode earliest):

partition  kafka-oldest   kafka-newest   consumed-to      consume-from   purge-rows
0          0              4              3                0              1

dry-run: nothing has been changed
Каждая строка плана соответствует одному разделу: kafka-oldest и kafka-newest — диапазон позиций, сохранённых в Kafka; consumed-to — текущая позиция потребления; consume-from — позиция, с которой начнётся потребление после сброса; purge-rows — количество записей, которые будут удалены из прогресса потребления при этом сбросе.
Пример: выполнение сброса
Если в файле конфигурации несколько потоков данных, укажите один из них параметрами выбора; -y пропускает интерактивное подтверждение:
$ mxgate offset-reset -C mxgate.toml \
    --topic orders \
    --consumer-group mxgate-orders \
    --job j_orders \
    --to-offsets '0:100' \
    -y
Выполнение и восстановление
--to-offsets. В этом случае завершите восстановление согласно сообщению и не запускайте поток данных, пока позиция Kafka не будет подтверждена как согласованная.Область влияния
reset_id.

