随着数据库成为支撑核心业务的重要基础设施,企业关注的已不只是数据能否安全保存,也包括生产集群不可用时,业务能否及时恢复。如何保护数据、缩短业务中断时间,并建立一套可执行的恢复流程,成为数据库可靠性建设必须解决的问题。
备份是这套体系的基础,但拥有备份,并不意味着已经具备灾难恢复能力。备份为数据的保存与找回提供基础,而灾难恢复 (Disaster Recovery,以下简称 DR) 进一步关注的是:当生产集群不可用时,灾备集群能否在数据一致、过程可控的前提下完成接管,支撑业务恢复。对于 MPP 分布式数据库,这一问题更为复杂。除了保证数据完整,主节点与各数据分片还需要恢复到彼此一致的状态,并完成集群角色与拓扑的相应调整。只有这些环节协同完成,灾备集群才能作为一个整体承接业务。
YMatrix DR 正是围绕这一目标设计的。它通过集群级物理复制,使灾备集群持续接收生产集群的数据变化;在需要接管时,以全局恢复点协调各个分片恢复到一致状态,再完成集群角色转换,使灾备集群具备独立提供读写服务的能力。
备份为数据恢复提供基础。根据备份方式和环境准备情况,恢复服务可能涉及机器准备、软件部署、数据还原、日志回放、集群校验以及应用连接调整,这些环节的耗时都需要纳入恢复计划。
对于核心业务,恢复方案还需要回答另一个核心问题:业务能够承受多长时间的中断?备份本身是否成功、数据能否找回,以及整个恢复过程能否满足 RTO,都是可靠性建设需要验证的内容。
在 MPP 分布式数据库中,恢复还涉及多个节点之间的协调。数据还原和日志回放需要覆盖各个分片,主节点与分片状态需要校验,应用也需要重新接入。数据规模、日志回放量、可用资源和操作流程,都会影响实际恢复耗时。如果这些工作集中在故障发生后完成,就会大大增加恢复时间和现场操作的不确定性。
YMatrix DR 在生产系统正常运行时,持续维护一套可用于接管的灾备集群。它通过集群级物理复制,为主节点和各数据分片建立持续同步的灾备环境。
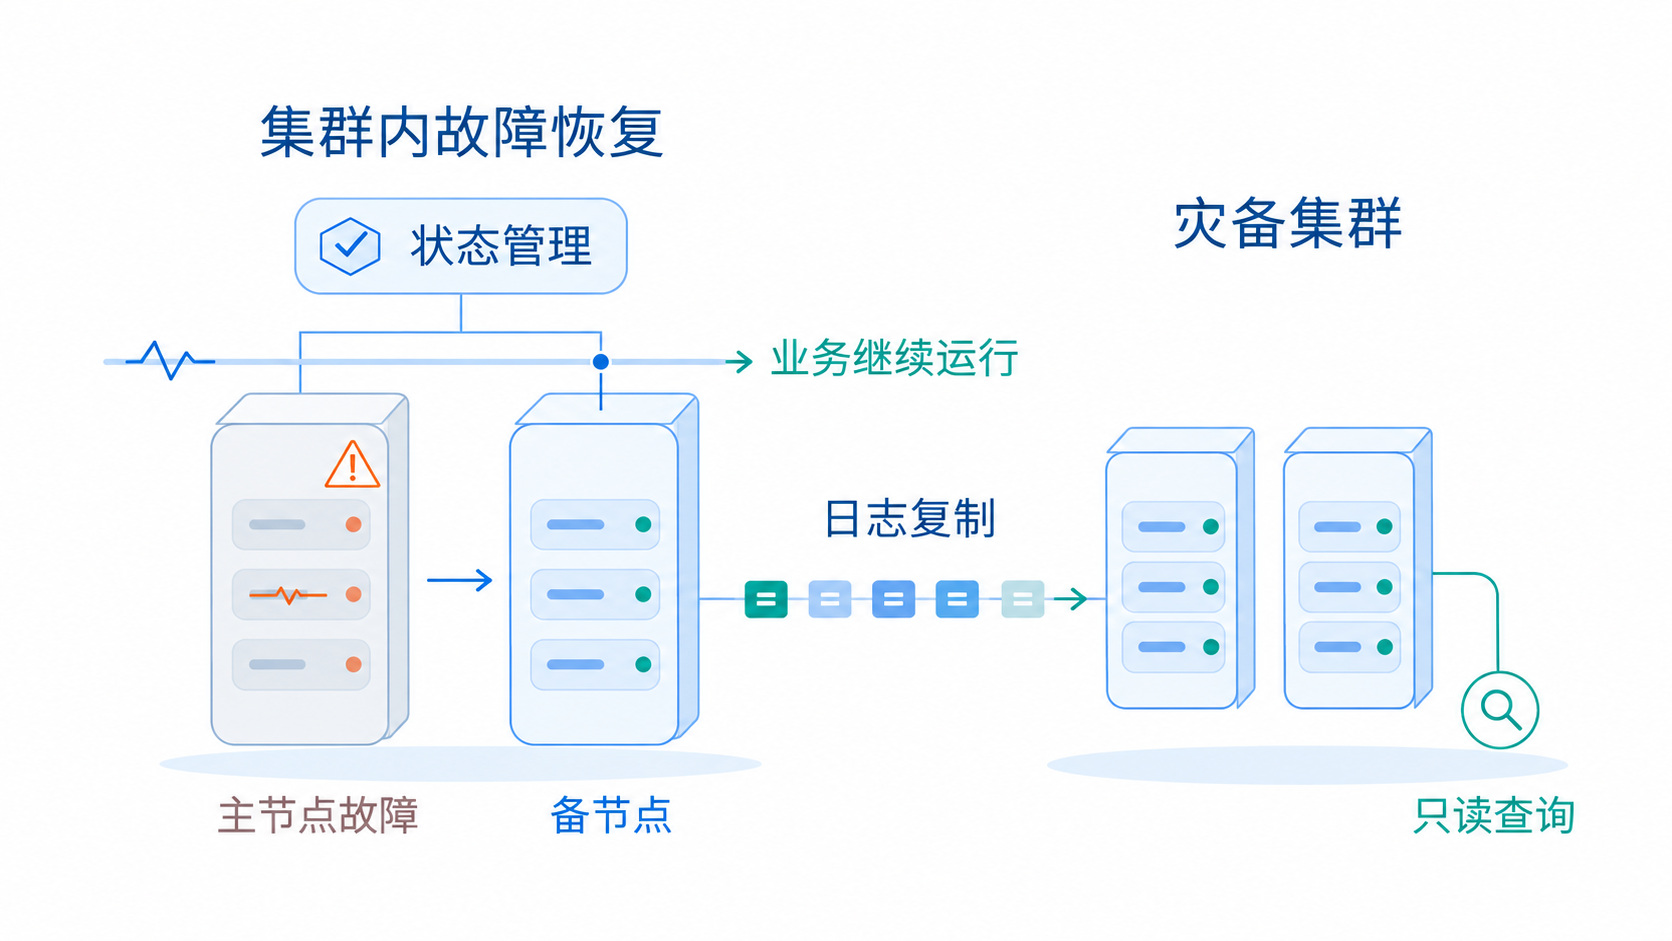
主集群承担日常读写,灾备集群可部署在另一数据中心,持续接收生产端的数据变化,并且支持只读查询。当需要接管时,团队可以基于已有的灾备集群推进恢复,减少临时搭建环境和全量还原数据的工作,为缩短业务中断时间、满足 RTO 目标提供基础。
MPP 数据库中的一笔事务可能同时修改多个分片,而灾备端各节点的日志回放进度可能存在差异。如果恢复后只有部分分片包含这笔事务的修改,就可能出现业务数据不一致。因此,集群恢复需要协调主节点与各分片的事务状态,不能仅以单个节点的恢复进度判断。
YMatrix DR 通过全局恢复点协调这一过程。主集群通过定期创建全局恢复点,记录主节点与各数据分片对应的 WAL 位置,并将这些位置关联为同一个一致恢复边界。灾备集群据此协调各节点的日志回放,在接管时恢复到该边界所定义的一致状态,再完成集群角色转换。
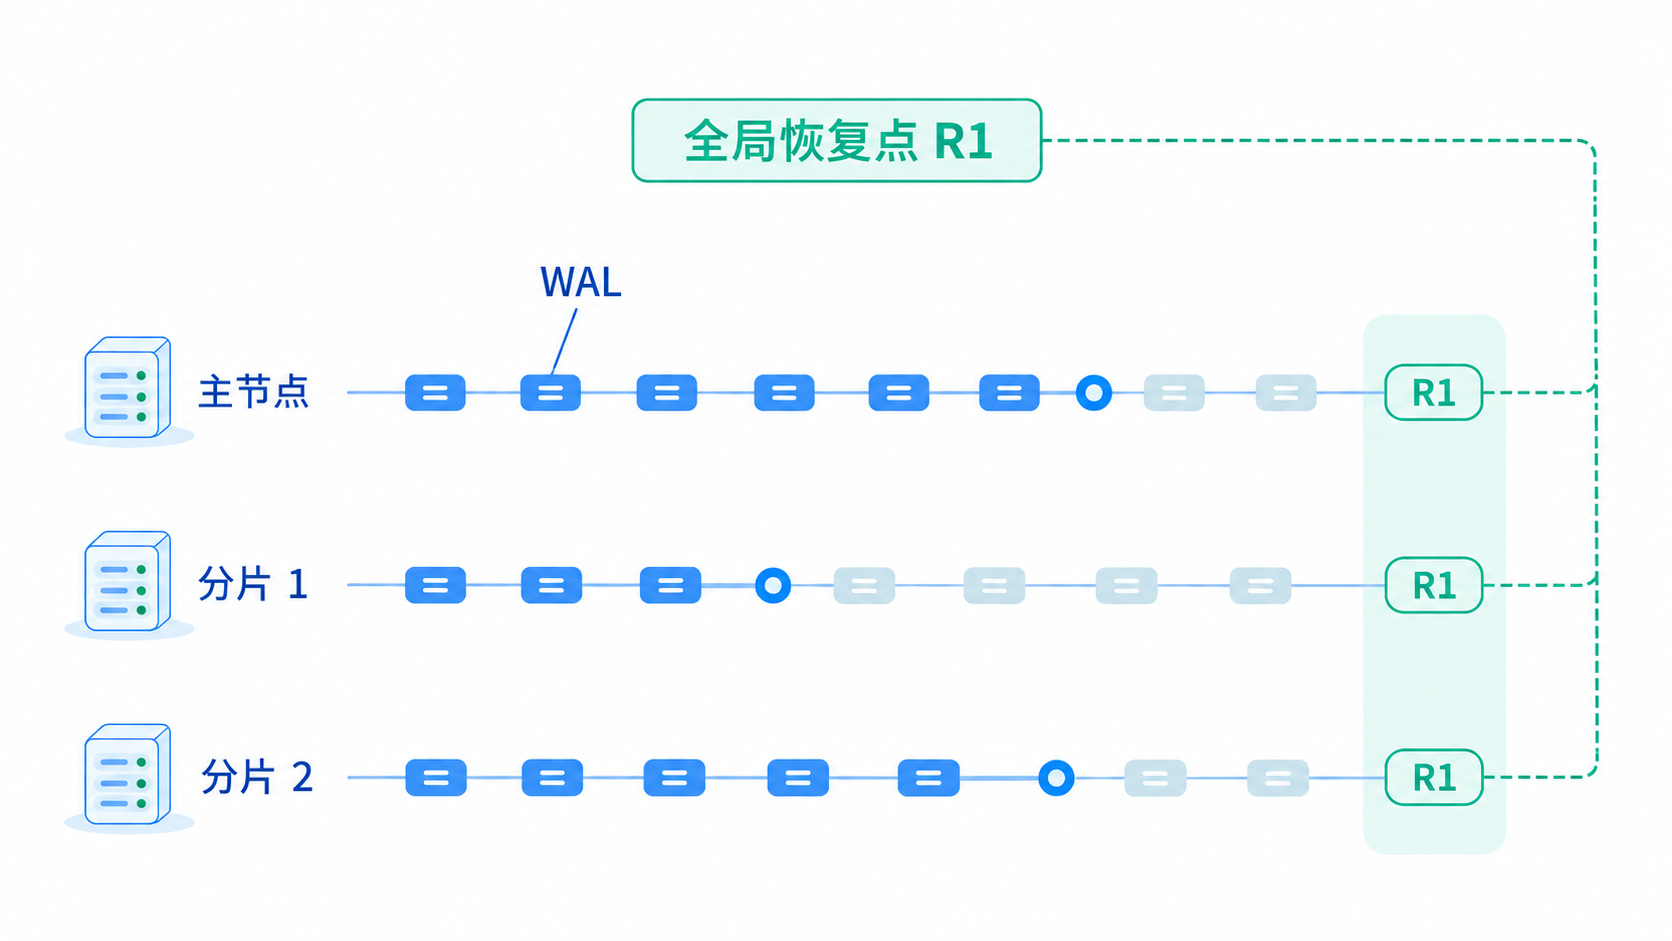
灾备集群支持只读连接,但在日志回放过程中,各分片可能处于不同的恢复进度,因此无法保证任意时刻的查询结果跨分片一致。所以我们在规划灾备端的查询用途时,需要考虑到这一限制。
灾备方案需要明确恢复点目标 (Recovery Point Objective,RPO),即业务能够接受的数据丢失范围,并据此选择复制方式。YMatrix DR 支持两种复制模式,在异步复制下,生产事务无需等待远端复制确认,对跨数据中心延迟更宽容,但复制滞后可能增加故障时的数据丢失范围。而同步复制需要等待远端确认,有助于加强数据保护,同时也会使事务提交受到远端延迟和链路状态的影响。企业可以结合业务对数据保护、事务响应时间的要求,以及跨数据中心的网络条件,灵活选择和调整复制模式。
当灾难导致生产集群无法继续提供服务,需要由灾备集群接管时,管理员应先确认故障范围与灾备状态,并确保原生产集群不会继续接受写入,避免两套集群同时承接写业务。确认满足接管条件后,在灾备集群的 master 节点上执行 mxdr switch,工具会自动完成主节点与各数据分片的角色提升,并更新本地集群拓扑。操作完成后,灾备集群便正式转换为了可独立提供读写服务的 YMatrix 集群。
YMatrix DR 通过集群级物理复制持续维护灾备副本,并以全局恢复点保障跨分片恢复的一致性。当生产集群整体不可用时,企业可基于已有灾备集群完成一致恢复与数据库接管,减少环境重建和全量数据还原的工作,缩短业务恢复时间。
配合同步、异步两种复制模式,YMatrix DR 可适应不同的数据保护目标、生产性能要求与跨中心网络条件,助力企业构建灵活、可靠的灾备体系,为核心业务连续运行提供保障。