在前两篇文章《百万 Token,却留不住一次经验:Agent 的记忆难题》和 《从数据到记忆:Cognee 如何构建 AI Agent 的长期认知》中,我们讨论了 Agent 为什么需要长期记忆,也沿着 Cognee 的处理过程,剖析了文档、对话与执行经历如何被组织成可以检索和关联的知识。
这些记忆会随着 Agent 的持续工作不断积累和更新。新的内容陆续加入,已有知识得到补充与修订,并在后续任务中被反复检索、关联和使用。数据库也因此需要持续管理这些知识:让同一份内容对应的文本、向量和关系保持联系,在知识规模增长时控制检索与计算成本,并在任务涉及实际业务时,支持已有记忆与当前数据的结合。
CittaBase 与 Cognee 的结合,正是围绕这些需求展开。Cognee 负责组织记忆的形成与使用,CittaBase 则提供统一的数据管理、语义检索与关系计算能力,共同支持 Agent 持续积累和使用知识。
在 Cognee 中,一份知识拥有多种表达:文本保留原始内容,向量提供语义检索入口,图关系连接实体,来源与状态记录则说明这些内容的归属与出处。这些数据各有用途,又彼此依赖。语义检索找到候选后,需要定位到具体的知识对象;沿关系找到实体后,需要追溯原文;删除一个来源时,还要区分哪些内容应当清理,哪些对象仍被其他来源使用。新增文档、修订知识或清理过期内容,都可能涉及多种数据的共同维护。对象分散在不同系统中时,应用还需要处理跨系统同步、标识映射和结果核对。
CittaBase 将关系、向量和图能力纳入同一套数据库体系,为这些相互关联的数据提供统一的管理基础。
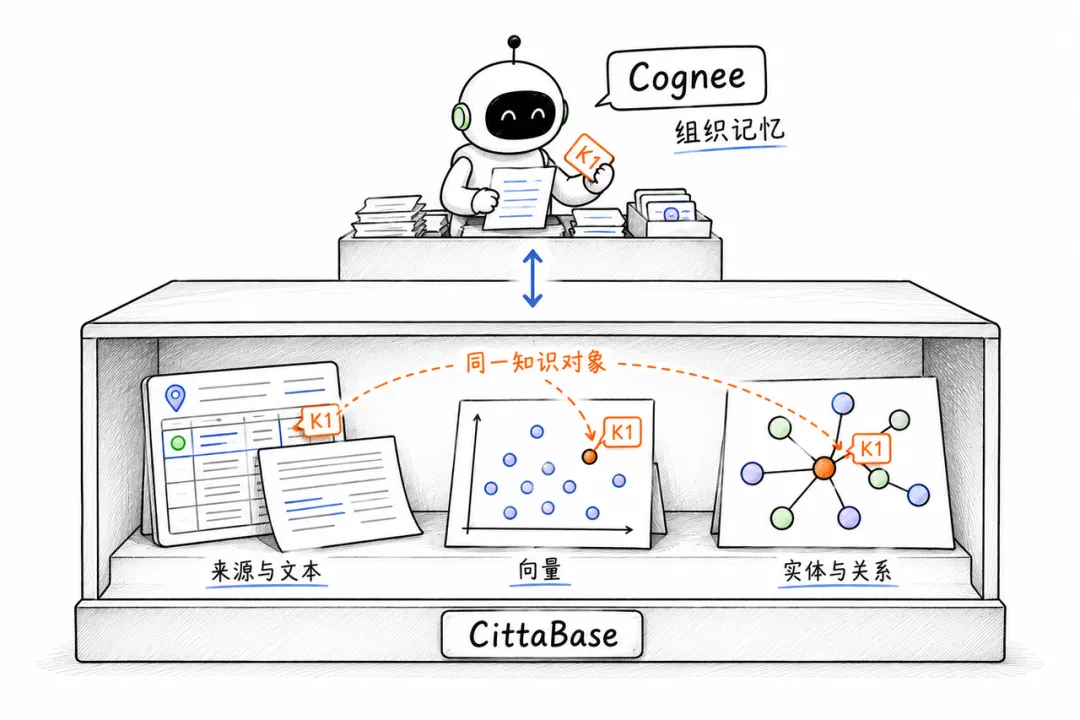
知识对象的身份、来源和状态通过关系数据管理,语义候选由向量引擎检索,实体之间的联系由图引擎组织和查询。应用可以根据对象标识,在这些数据之间建立对应关系,查找相关内容、追溯出处,并结合来源与状态限定使用范围,减少跨系统传递和核对数据的工作。
记忆的使用涉及多种访问方式:关系查询按明确条件筛选和关联数据,向量检索寻找语义相关的内容,图查询沿实体之间的联系展开。随着知识增长,这些操作既要返回合适的结果,也需要控制数据访问与中间计算的开销。CittaBase 为三类查询提供相应的表达方式,并在索引与执行层优化处理过程。
PostgreSQL 正成为 AI 应用的重要技术基础。成熟的关系处理能力、开放的扩展体系,以及围绕它不断丰富的 AI 开发工具,让企业已有的数据与技术积累能够继续服务于新的应用需求。对于开发者,熟悉的 SQL、驱动和管理工具,也意味着更低的接入与维护成本。
CittaBase 延续 PostgreSQL 的关系处理能力与生态优势,并增强图计算和向量检索。开发者可以在同一套数据库中使用 SQL 筛选、关联和汇总业务数据,通过向量与图查询获取相关知识,并借助事务、约束和并发控制维护任务状态与数据完整性。从业务数据管理到 AI 知识检索,这些能力共同服务于 Agent 的任务执行。
在 Cognee 的记忆体系中,关系数据记录知识的来源、版本和归属。当任务需要了解当前业务时,应用还可以通过业务标识,将召回的知识与相关记录关联起来,让 Agent 在参考历史经验的同时,也能实时了解当前的业务状态。
在 Cognee 中,一篇文档经过处理,可能产生文本片段、摘要和实体等多种知识对象,其中不少对象都拥有独立的向量表示。随着文档、对话和执行经历不断积累,Agent 每次需要找回的可能只是几条相关信息,数据库面对的候选集合却在持续扩大。高维向量包含大量数值,读取这些数据、计算距离,再选出最接近的结果,都需要消耗存储带宽和计算资源。因此,向量检索除了关注能否找到相关内容,还需要考虑:一次召回究竟要访问多少数据,又有多少候选值得进行精细计算?
CittaBase 的向量引擎将搜索范围选择、量化筛选与候选重排结合起来,在索引内部完成分阶段检索。向量索引可以通过聚类,将向量划分到不同区域,使相近的向量尽量集中。查询时,根据查询向量选择相关区域,缩小需要检查的范围。在这些区域内部,再使用更紧凑的量化表示估算距离,筛选可能进入结果集的候选,减少这一阶段的数据读取与计算开销。
经过初步筛选,对仍有竞争力的候选使用原始精度向量重新计算距离,进一步确定排序。大范围筛选使用轻量的表示,精细计算则集中在保留下来的候选上,避免对大量无关内容投入同等的计算成本。这里的重排由向量检索引擎完成,无需额外调用大模型。
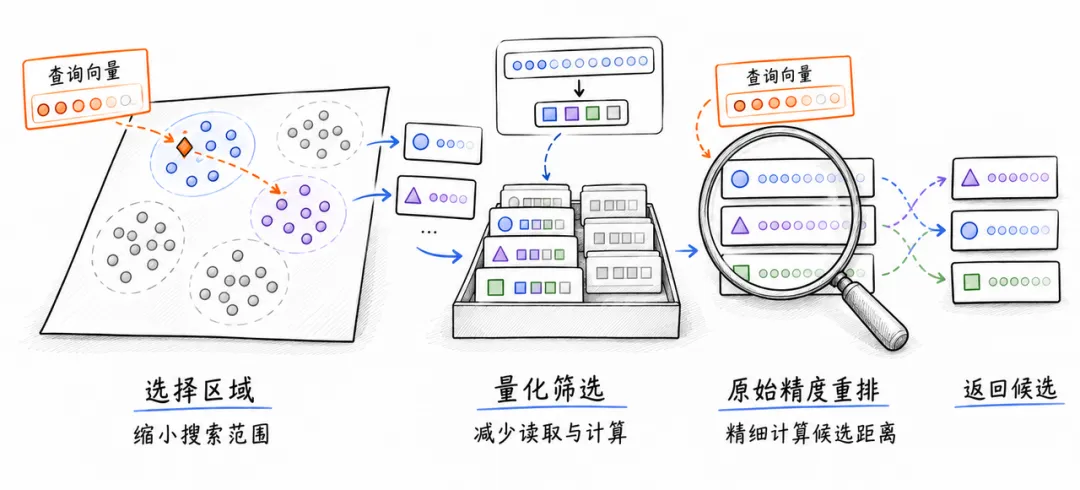
这些处理发生在数据库内部,应用仍然可以沿用熟悉的向量距离查询方式。以 Cognee 的实体向量表Entity_name为例,应用通过参数传入查询向量,查找距离最近的五个实体:
SELECT id
FROM "Entity_name"
ORDER BY vector <=> $1::vector
LIMIT 5;其中,$1 是应用传入的查询向量,<=> 表示余弦距离。建立相应索引后,数据库可以为这样的查询选择向量索引执行路径,应用无需自行编写候选筛选与向量重排逻辑。
对于持续运行的 Agent,团队可以随着知识规模和召回要求的变化,在 CittaBase 中调整索引与查询策略,在召回效果和资源消耗之间选择合适的配置,同时沿用已有的数据组织与查询接口。
Cognee 通过知识图连接分散的实体与信息,为 Agent 提供关联上下文。沿用前文的知识图,我们从 mars3 bucket 出发,沿出边查找一到两跳内能够到达的实体,看看同一个关系查询在两种后端中如何表达。
在原生 PostgreSQL 图后端中,节点和边保存在关系表里,查询需要通过递归 CTE 逐层展开,显式维护深度与边访问记录,再对返回的实体进行筛选和去重。CittaBase 内置图引擎,可以通过 Cypher 直接描述起点、关系方向和路径范围,将匹配与遍历交由数据库处理:
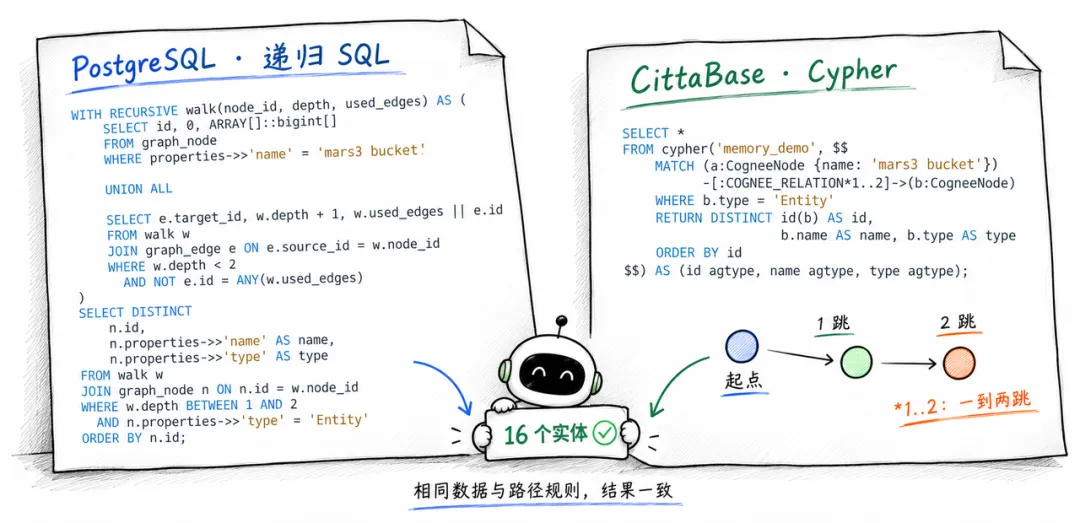
图中的*1..2指定一到两跳,箭头表示遍历方向。在相同图数据和路径规则下,两种查询均返回 16 个不同实体,核对后的对象标识、名称和类型一致。开发者可以直接围绕实体之间的联系表达查询,减少自行编写和维护递归逻辑的工作。
随着关系增多、路径加深,图查询还需要控制中间结果带来的计算开销。CittaBase 针对多跳遍历优化执行方式,在适用的查询中通过剪枝减少无效路径探索,并针对路径计数等需求省去不必要的结果构造。这些能力与关系数据处理共同运行于同一数据库中,让应用既能沿知识网络寻找关联信息,也能结合来源、状态与业务记录进一步查询。
沿着知识关系找到相关对象后,Agent 往往还需要结合业务数据继续判断。历史经验是否适用于当前情况,同类问题近期出现了多少次、集中在哪些范围,都需要进一步查询。这些操作将知识检索延伸到了业务计算,也让数据库需要处理的数据范围随之扩大。
读取某个对象的状态,通常只涉及少量记录;分析一段时间内的变化,则可能需要扫描大量数据,再进行关联、聚合与排序。CittaBase 通过 MARS3 行列混存与向量化执行,从存储和计算两方面支持这类分析需求。MARS3 兼顾日常读写与分析访问,利用列式组织按需读取字段,减少无关数据的读取;向量化执行则以批量方式处理数据,降低逐行执行的开销,提高过滤、关联与聚合的效率。
业务数据还在持续变化,分析结果也需要随之更新。Domino 库内流通过 SQL 定义过滤、关联与聚合等加工逻辑,在源数据新增、修改或删除后,自动增量更新下游结果。对于需要反复查询的统计指标,应用可以直接读取持续维护的结果,减少重复扫描与计算。数据加工在数据库内部完成,也减少了额外部署流处理系统、维护跨系统加工链路的工作。
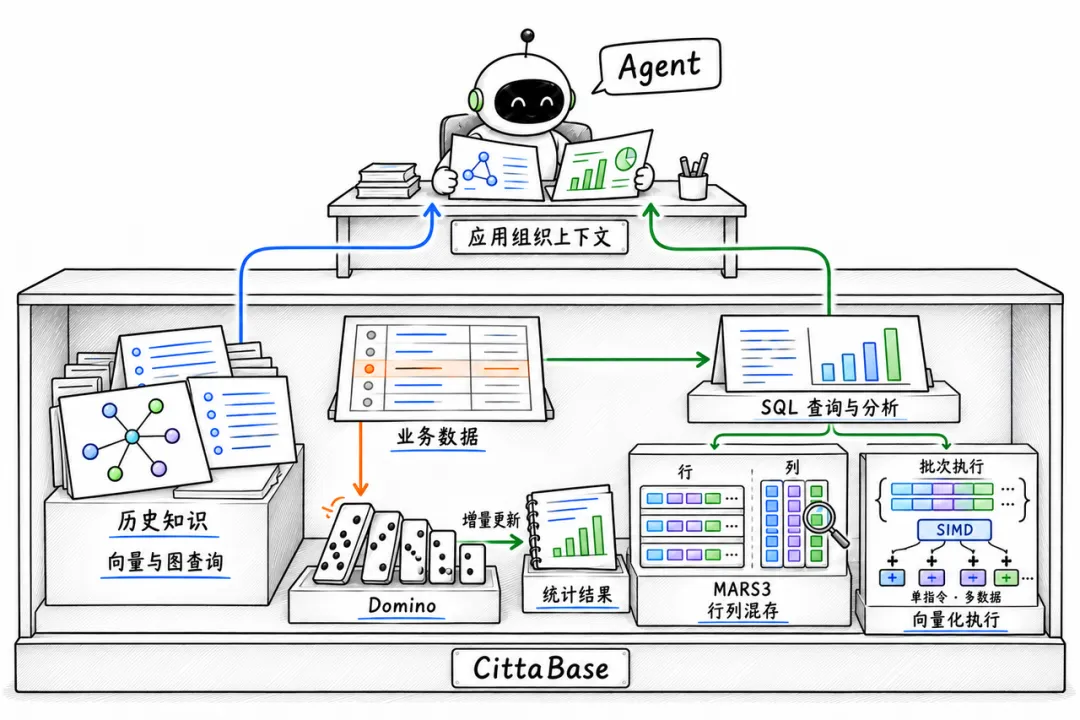
从知识召回,到业务分析,再到分析结果的持续更新,应用可以在同一套数据库中完成这些相互衔接的工作,让 Agent 将已有经验与及时更新的业务事实结合起来,形成更充分的判断依据。
过去的处理经验能否被找到,分散的知识能否沿关系连接,历史结论能否结合当前数据重新判断,都离不开数据库的支撑。Cognee 负责组织和调用记忆,CittaBase 则承接这些记忆背后的数据管理、检索与计算。
CittaBase 立足于 PostgreSQL 生态,将关系处理、向量检索与图计算结合,并通过行列混存、向量化执行和库内流,支撑业务分析与数据的持续加工。统一的数据管理与针对性的执行优化,让知识和业务数据能够在共同的基础上被组织、查询和使用。
从记忆的组织与调用,到知识和业务数据的共同使用,CittaBase 正在构建面向 AI 应用的一体化全栈多模数据底座。